그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -4-


SFT 모델로 만든 추천사유 13.5만 건, 기존 서비스 방식보다 4.5배 더 빠르게
이전 포스트에서는 Hugging Face로 만들던 추천사유를 vLLM으로 바꿔 봤다. 같은 모델 같은 일을 시켰는데 엔진만 바꿔서 전체가 2.6배 빨라졌다.
특히 문장을 쓰는 생성 단계에서 차이가 컸는데 짧은 문장이 긴 문장을 기다리는 낭비를 vLLM이 없애 주었기 때문이다.
더 최적화 할 수 있는 방법이 하나 남아 있었다.
모든 질문은 같은 지시문으로 시작하는데, 지금은 이 부분을 질문마다 처음부터 다시 읽고 있다. 이번 글에서는 엔진은 그대로 두고, 이미 읽은 것을 다시 읽지 않게 만들어 보기로 했다.
1. 모든 질문은 같은 지시문으로 시작한다
1) 질문의 절반은 똑같다
모델에게 보내는 질문은 우리가 쓴 지시문만으로 이뤄지지 않는다. 모델이 대화의 구조를 알아볼 수 있도록 앞뒤에 특수 토큰이 붙는다. 글의 시작을 알리는 토큰, 누구의 차례인지 알리는 토큰 같은 것들인데 표시는 모델마다 다르다.
같은 대화라도 Llama 3는 <|begin_of_text|>, Qwen은 <|im_start|>로 시작한다. 그래서 직접 쓰지 않고 모델에 딸린 채팅 템플릿(apply_chat_template)이 만들게 한다.
이번에 쓴 Gemma 3는 질문을 이렇게 감싼다.
<bos>: 글의 시작<start_of_turn>user…<end_of_turn>: 사용자의 차례<start_of_turn>model: 모델이 답할 차례
Gemma에는 시스템 지시문을 위한 차례가 따로 없어서, 지시문은 첫 번째 사용자 차례의 맨 앞에 붙는다.
추천사유를 받기 위해 모델에 던지는 질문을 토큰 단위로 펼쳐 보면, 실험한 1만 개의 질문이 모두 같은 73토큰으로 시작한다.
<bos><start_of_turn>user
장보기 앱에서 추천 상품 아래에 붙는 설명을 씁니다. 근거 상품과 추천 상품을 함께 쓰는 쓰임을
1~2문장, 50자 이내의 해요체로 쓰고, 둘을 함께 쓰는 요리가 분명하지 않으면 skip합니다.
JSON으로만 답합니다.

{"recommended_item":
그리고 나서, 추천 상품 이름("당근(봉)" 같은)부터 질문마다 달라진다. 질문 하나의 길이가 153토큰 안팎이니, 질문의 절반이 똑같은 셈이다.
2) Prefix 캐시
KV 캐시는 질문 하나 안에서 이미 읽은 토큰의 계산 결과를 저장해 두는 것이라고 했다. prefix 캐시는 이걸 질문 사이로 넓힌다. 앞부분이 똑같은 질문이 들어오면, 앞서 만든 KV 캐시를 그대로 가져다 쓰고 그 부분의 계산을 건너뛴다.
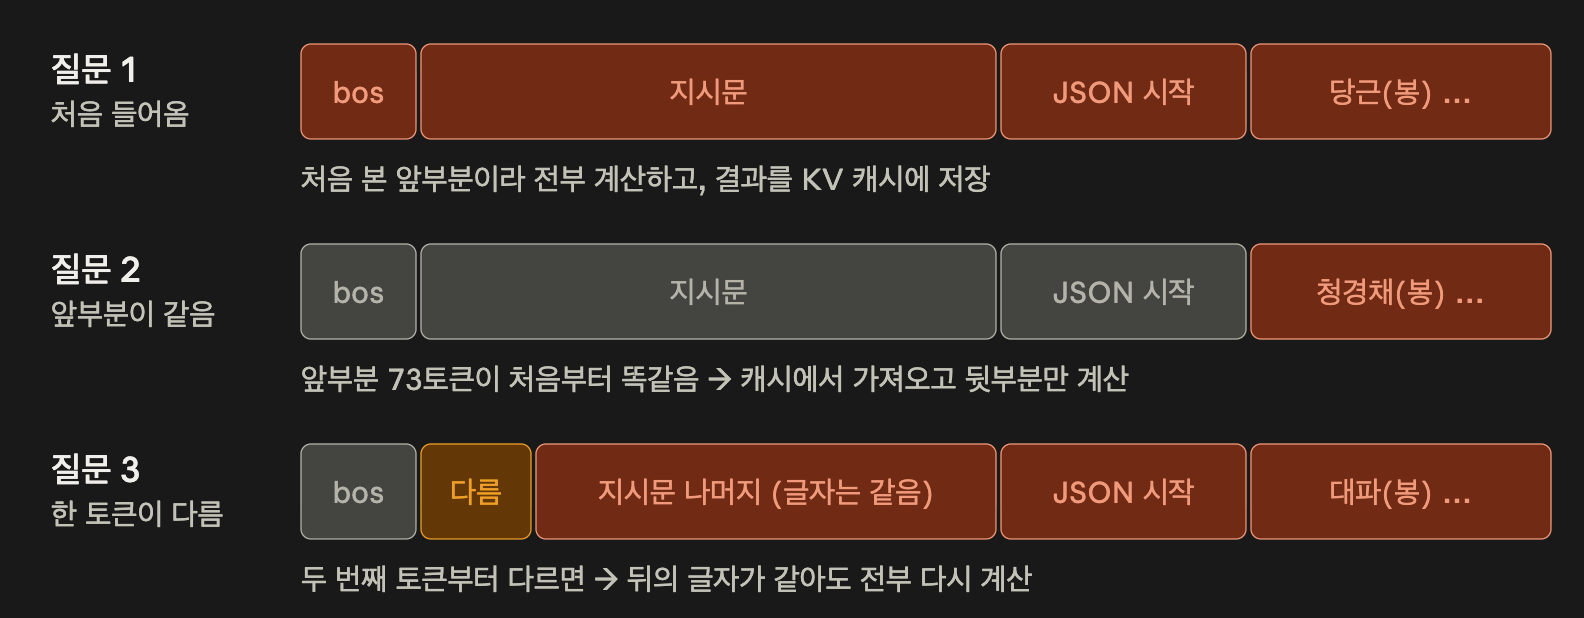
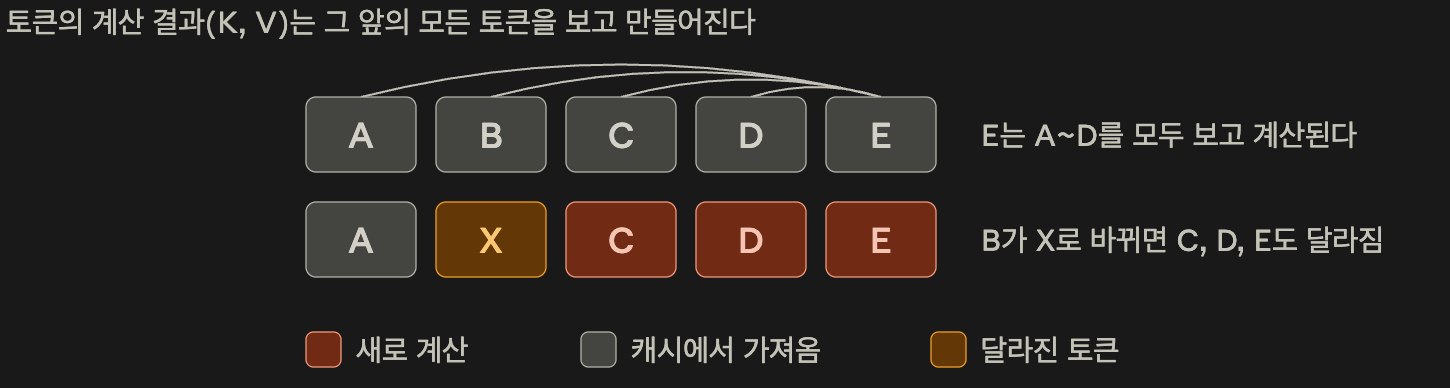
조건이 하나 있다. KV 캐시에 저장되는 건 토큰의 글자가 아니라 계산 결과인데, 이 계산 결과는 그 앞의 모든 토큰을 보고 만들어진다.
그래서 재사용할 수 있는 건 처음부터 토큰 하나까지 똑같은 앞부분뿐이다. 중간에 한 토큰만 달라도, 그 뒤는 글자가 같더라도 전부 다시 계산해야 한다.
vLLM에서는 이 prefix 캐시를 설정 하나로 켤 수 있다.
llm = LLM(model="학습한 모델 경로", enable_prefix_caching=True)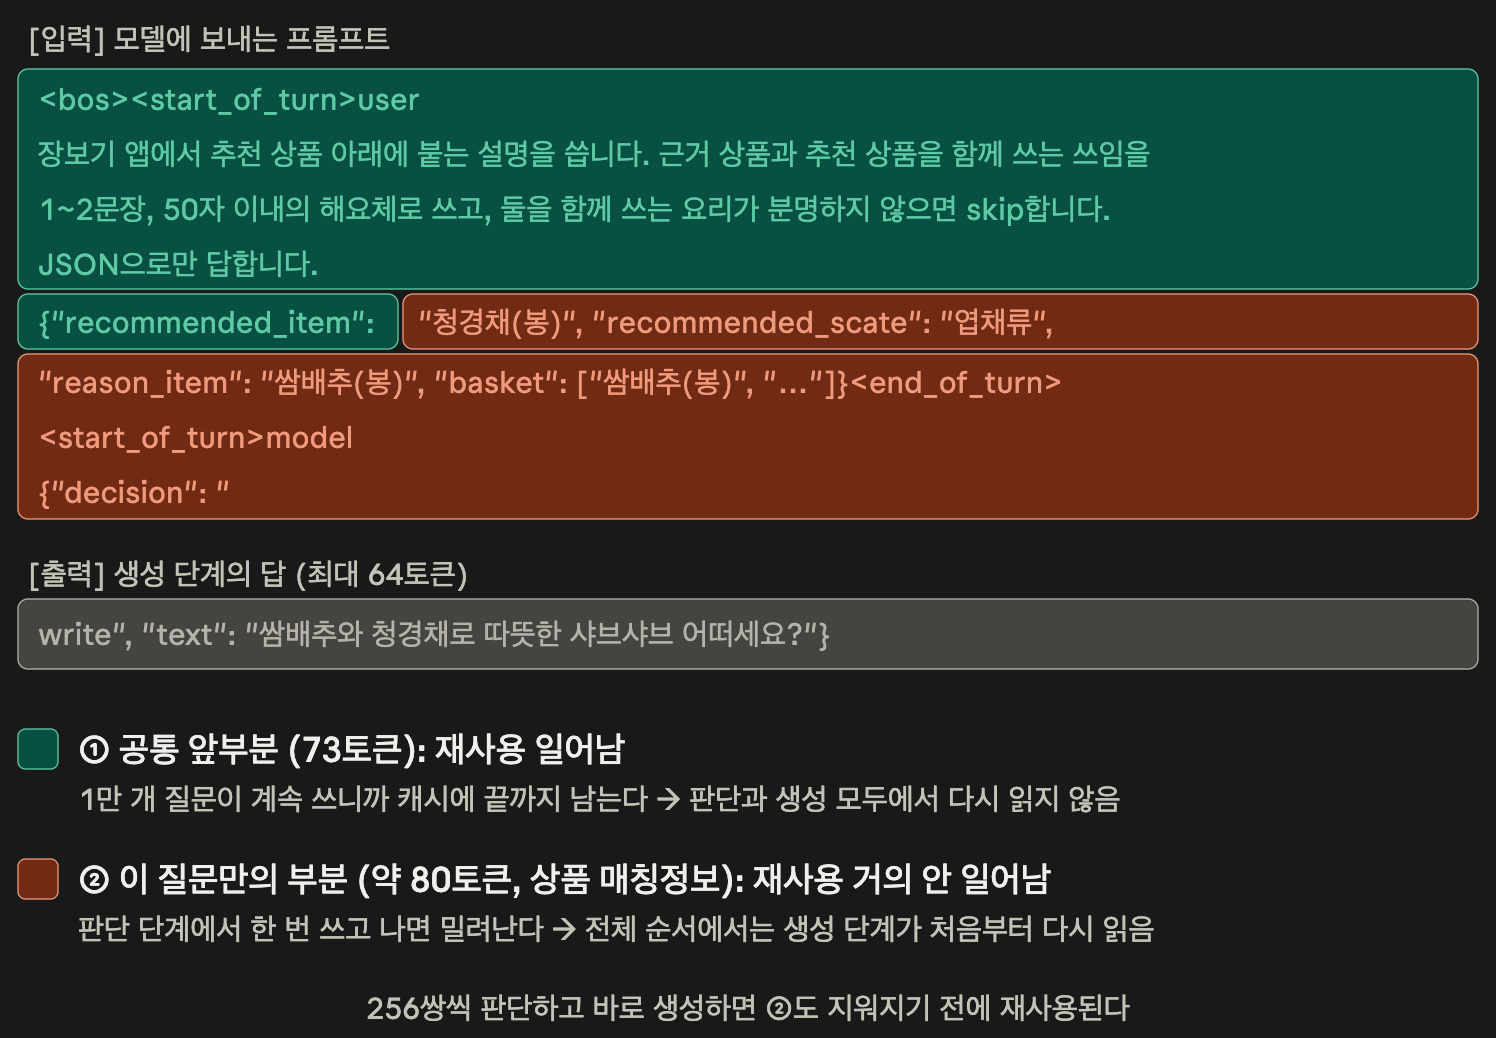
3) 판단 단계가 절반으로
이전 포스트와 같은 조건(같은 16비트 모델, L4, 1만 쌍)에서 캐시만 켜 봤다.
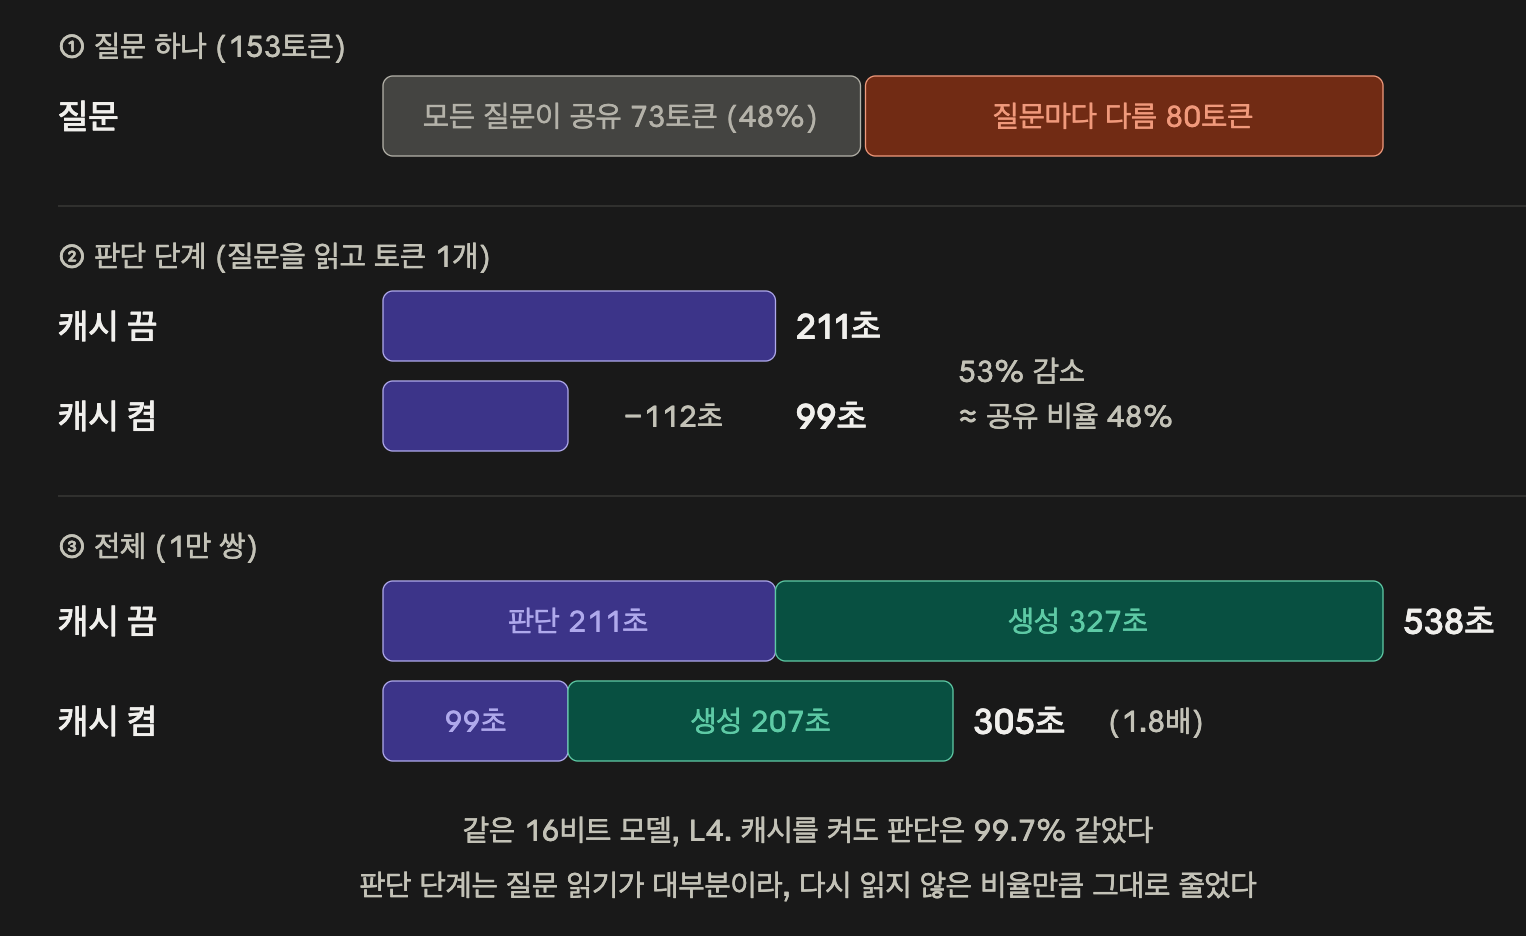
그림과 같이 prefix 캐시를 켜니까 판단 - 생성, 두가지 단계중 판단 단계가 211초에서 99초로 거의 절반이 줄었고, 생성단계 또한 327초에서 207초로 줄었다. 생성단계 또한 줄어든 이유는 vLLM은 여러 질문의 "읽기"와 "쓰기"를 한 번에 섞어서 처리하기 때문에, 읽어야 할 양이 줄면 그만큼 GPU를 문장 쓰기에 더 쓸 수 있기 때문이다.
4) 고정된 부분을 앞에 놓기
고정된 지시문이 맨 앞에 있었기 때문에 공유가 가능했다. 만약 질문마다 달라지는 상품 정보를 앞에 두고 지시문을 뒤에 붙였다면, 공유되는 앞부분은 몇 토큰에 불과했을 것이다. 프롬프트는 고정된 부분을 앞에, 바뀌는 부분을 뒤에 두는 게 좋다.
2. 캐시는 지워지기 전에 써야 한다
1) 판단 단계에서 읽은 질문을 생성 단계가 다시 읽는다
생성을 두 단계로 나눴는데, 판단 단계에서는 write 할지 skip 할지를 정하고, 쓰기로 한 추천상품 한 쌍만 생성 단계에서 추천사유를 끝까지 쓴다.
그런데 이전에 다루지 않은 부분이 하나 있다. 당연한 것인데 생성 단계는 판단 단계의 결과를 이어받지 않고, 같은 질문을 처음부터 다시 보낸다.
두 단계는 같은 질문을 보내되, 답을 얼마나 길게 받느냐만 다르다. 생성 단계의 모델은 첫 토큰으로 write를 다시 만들고, 이어서 문장을 쓴다.
이렇게 만든 이유는 단순해서다. 판단 단계가 끝나면 생성은 거기서 일단 멈추고, 결과(skip 확률)만 남는다. 그 결과로 쓸 쌍을 골라 생성 단계에서 다시 요청하는 게 코드로는 가장 간단했다. 대신 문장을 쓰는 쌍은 같은 질문을 두 번 읽는다. 판단 단계에서 한 번, 생성 단계에서 또 한 번.
그런데 두 질문이 처음부터 끝까지 완전히 같다는 건, 앞에서 본 prefix 캐시의 조건을 가장 완벽하게 만족한다는 뜻이기도 하다.
위 1) 에서는 서로 다른 질문끼리 앞부분 73토큰을 공유했지만, 여기서는 질문 전체(약 153토큰)를 공유한다.
판단 단계에서 만든 KV 캐시가 남아 있기만 하면, 생성 단계는 질문을 하나도 다시 읽지 않고 바로 답을 쓰기 시작할 수 있다.
두 단계의 예시를 보면 이해가 더 빠를 수 있겠다.
- 판단단계 : 질문을 넣고 답은 write 또는 skip 이다
[입력]
<bos><start_of_turn>user
장보기 앱에서 추천 상품 아래에 붙는 설명을 씁니다. 근거 상품과 추천 상품을 함께 쓰는 쓰임을
1~2문장, 50자 이내의 해요체로 쓰고, 둘을 함께 쓰는 요리가 분명하지 않으면 skip합니다.
JSON으로만 답합니다.

{"recommended_item": "청경채(봉)", "recommended_scate": "엽채류", "reason_item": "쌈배추(봉)", "basket": ["쌈배추(봉)", "…"]}<end_of_turn>
<start_of_turn>model
{"decision": "

[출력]  최대 1토큰
write- 생성단계 : 같은 질문을 넣고 답은 추천상품에 맞는 사유를 출력한다
[입력]
<bos><start_of_turn>user
장보기 앱에서 추천 상품 아래에 붙는 설명을 씁니다. 근거 상품과 추천 상품을 함께 쓰는 쓰임을
1~2문장, 50자 이내의 해요체로 쓰고, 둘을 함께 쓰는 요리가 분명하지 않으면 skip합니다.
JSON으로만 답합니다.

{"recommended_item": "청경채(봉)", "recommended_scate": "엽채류", "reason_item": "쌈배추(봉)", "basket": ["쌈배추(봉)", "…"]}<end_of_turn>
<start_of_turn>model
{"decision": "

[출력]  최대 64토큰
write", "text": "쌈배추와 청경채로 따뜻한 샤브샤브 어떠세요?"}
위 두 단계를 다시 보자. 생성 단계에 들어가는 질문은 판단 단계의 질문과 완전히 같다.
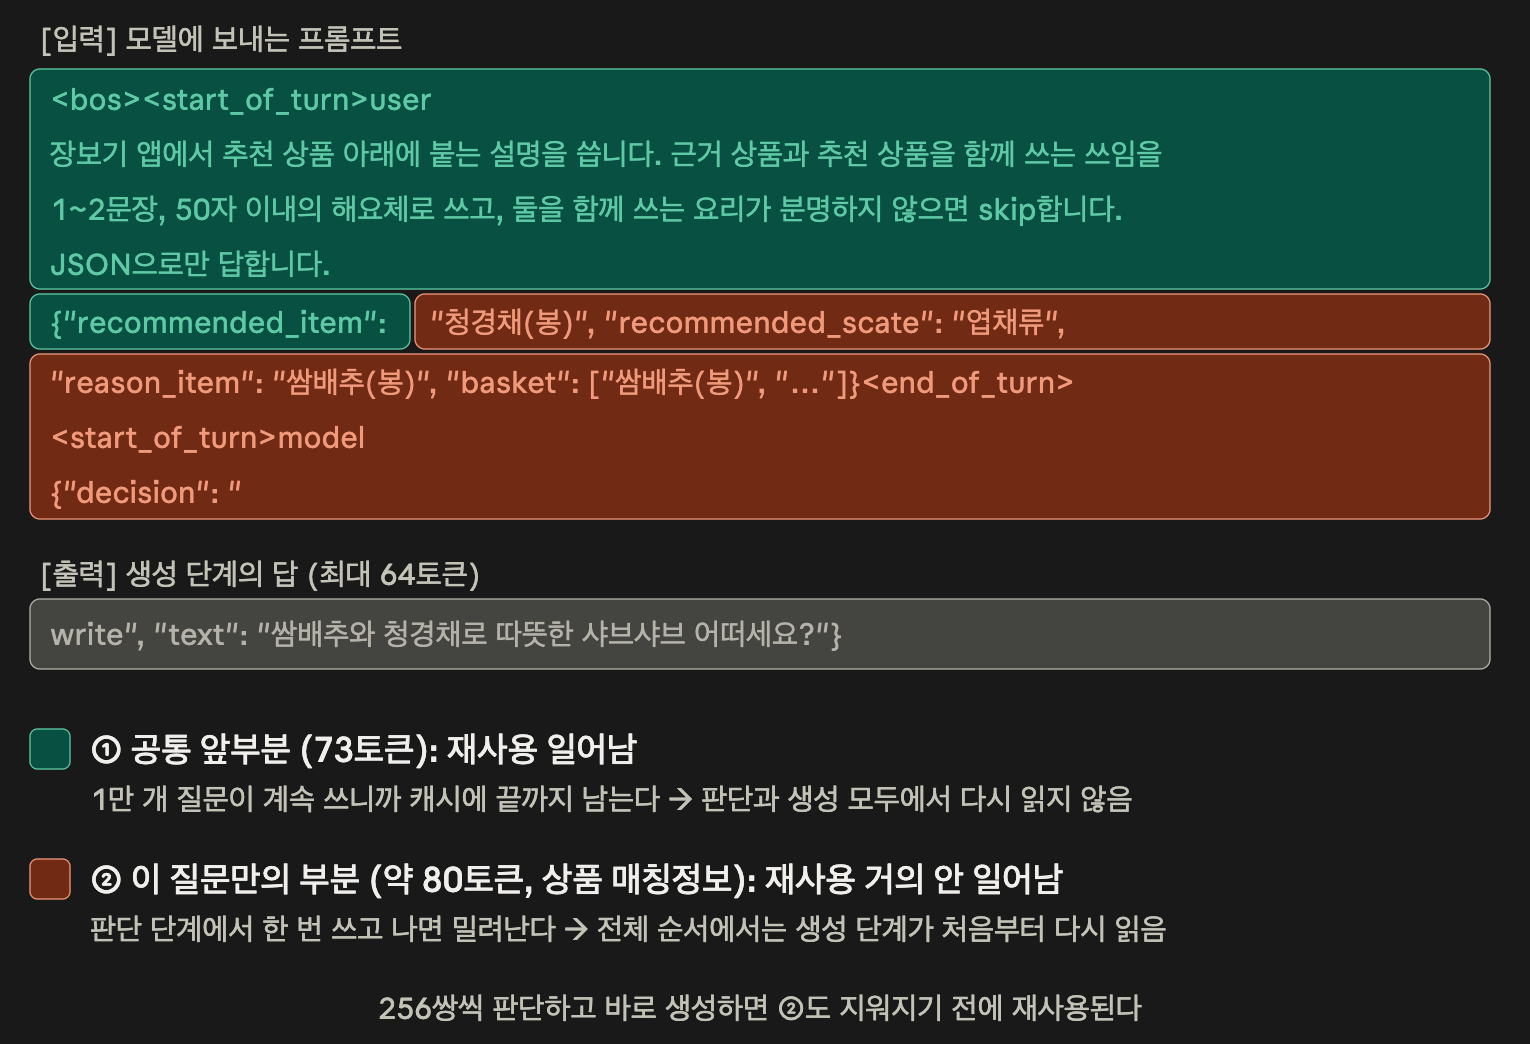
판단 단계에서 이미 질문 전체를 읽었으니 그 KV 캐시가 남아 있다면 생성 단계는 질문을 통째로 건너뛰고 바로 문장을 쓰기 시작할 수 있다.
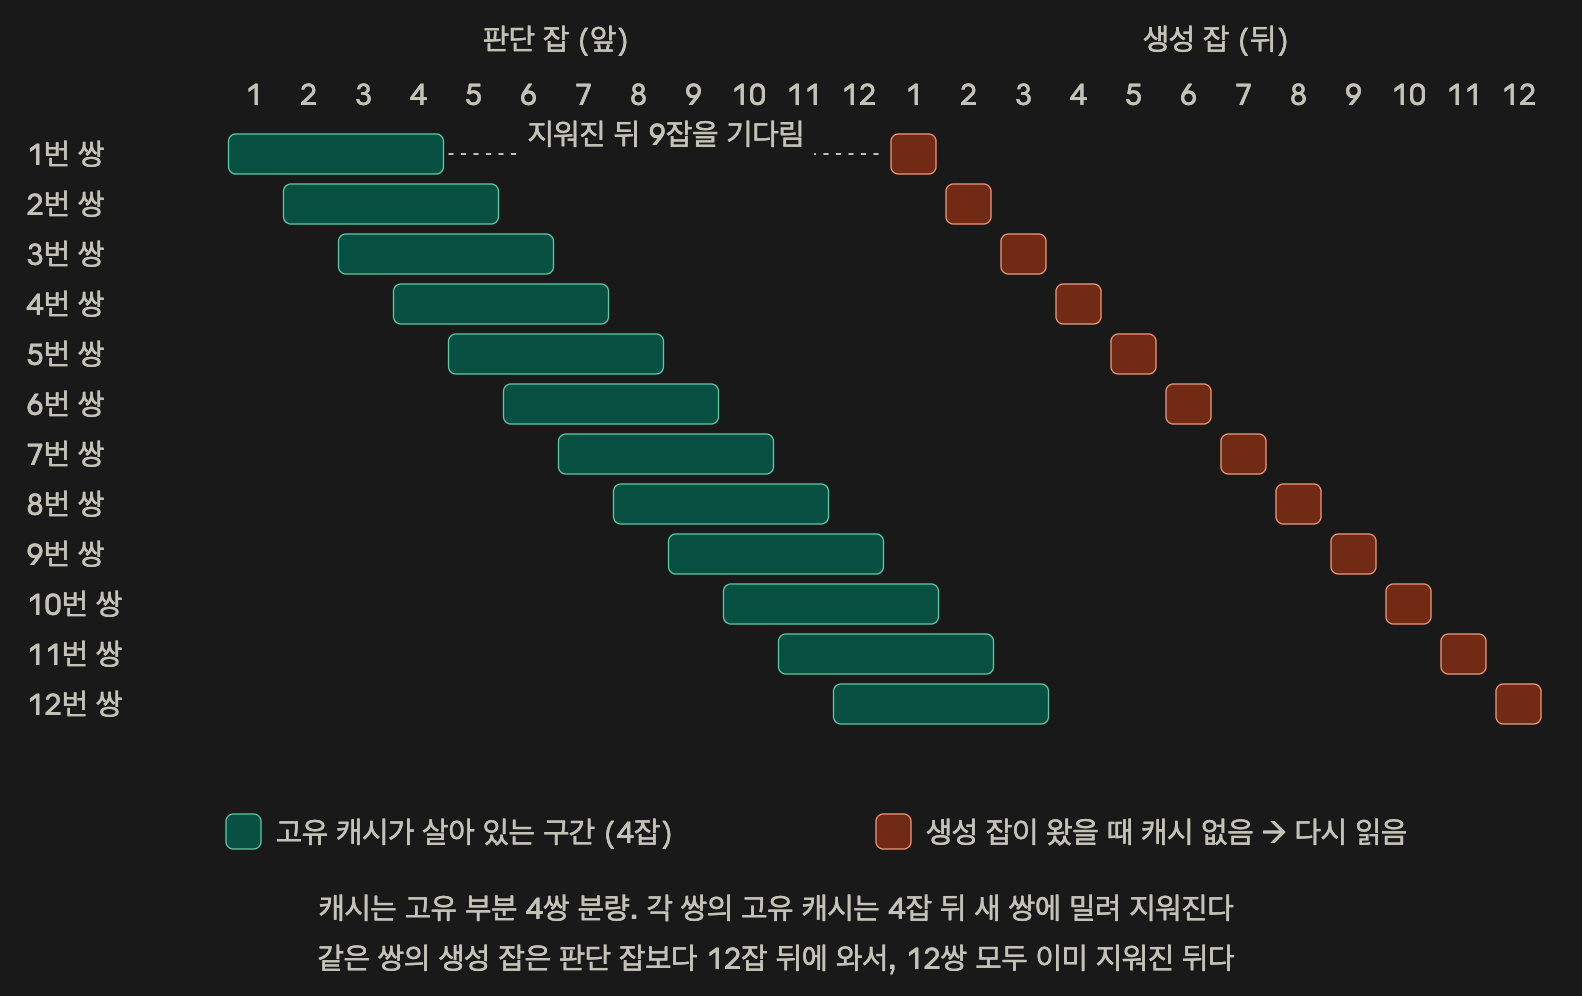
그런데 캐시를 켜도 이 재사용은 거의 일어나지 않았다. 이유는 캐시의 크기에 있었다.
다시 우리가 판단, 생성으로 두 단계에 거쳐서 모델에게서 답을 나누어 받는 이유는 생성배치 안에서 각기 다른 답변의 길이 때문에 생기는 불필요한 대기를 줄이려는 점이었다.
KV 캐시가 재사용이 일어나지 않은 과정을 다시 짚어보면, 아래 그림과 같이 크게 판단 단계, 생성 단계 둘로 나누어 볼수 있는데 위 그림의 붉은 부분이 문제가 되는 부분이다. 이 부분은 판단때 이미 한번 고유하게 생성(캐시1)이 되고 KV 캐시에 들어가 있을 것이다. 하지만 모든 판단 잡이 끝나고 나서 생성 잡이 시작될때쯤이면 KV 캐시에 들어가 있던 고유한 값(캐시1)은 한정된 메모리 영역에서 이미 다른 값(캐시?)으로 덮어씌워져 있을것이다.
- vLLM이 L4에서 잡은 KV 캐시 자리: 6.5만 토큰
- 1만 쌍의 판단 단계에서 읽는 질문: 1만 × 약 150토큰 = 약 150만 토큰
2) 순서를 바꾸다
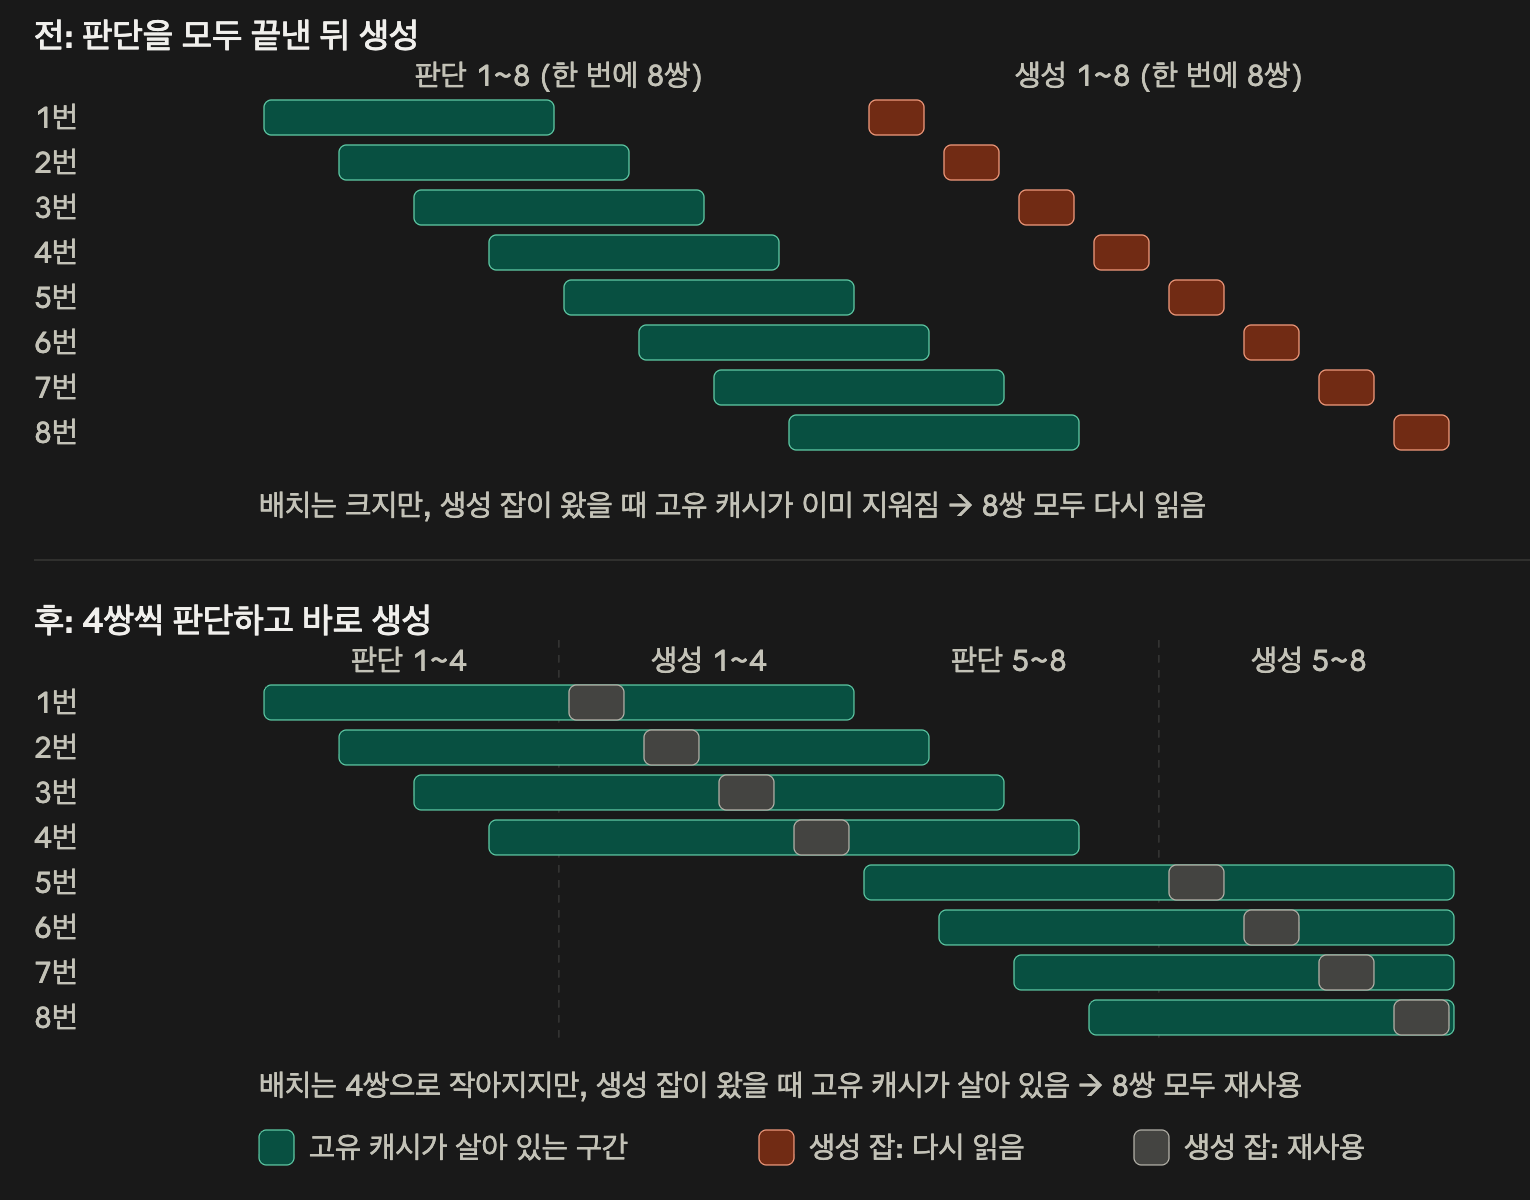
그래서 작업 순서를 바꿨다. 1만 쌍의 판단을 한꺼번에 끝내는 대신, 256쌍씩 판단하고 바로 그 256쌍의 문장을 생성했다. 256쌍이면 약 4만 토큰이라 캐시 자리에 넉넉히 들어간다. 판단 단계에서 읽은 질문이 지워지기 전에 생성 단계가 바로 가져다 쓰는 것이다.
| 설정 | 판단 단계 | 생성 단계 | 전체 |
|---|---|---|---|
| 캐시 켬, 전체 순서 | 99초 | 207초 | 305초 |
| 256쌍씩, 캐시를 비움 (재사용 없음) | 110초 | 260초 | 370초 |
| 256쌍씩, 캐시 재사용 | 99초 | 162초 | 261초 |
캐시를 비웠을 때와 남겨 뒀을 때를 비교하면, 재사용만으로 생성 단계가 38% 줄었다(260초 → 162초). 256쌍씩 나누면 vLLM에 한 번에 넘기는 질문이 줄어서 배치를 크게 짜지 못한다. 캐시를 비운 실행(370초)이 전체 순서(305초)보다 느린 게 그 대가다.
3) 캐시는 켜는 것보다 쓰는 순서가 중요하다
캐시는 켜 두기만 하면 알아서 재사용되는 게 아니었다. 캐시 자리는 한정되어 있고, 기다리는 사이에 지워진다. 재사용할 때까지 남아 있도록 작업 순서를 짜야 효과를 볼 수 있다.
여기까지 정리하면, 같은 16비트 모델에서 엔진만 바꾼 3편의 결과(538초)를 캐시와 순서로 다시 2배(261초) 빠르게 만들었다.
3. 그래서 13.5만 건이었다면
1) 서비스 방식과 같은 판단을 하는 모델로
이번에는 순수 Hugging Face가 아니라, 실제로 13.5만 쌍을 만든 방식(Unsloth로 4비트 모델을 불러와 배치 생성)이다. 생성 단계에서 처리할 쌍은 서비스 모델의 판단대로 5,499쌍으로 고정했다.
2) 서비스 방식과 같은 판단을 하는 모델로
| 방식 | 판단 단계 | 생성 단계 | 전체 | 서비스 방식 대비 |
|---|---|---|---|---|
| 서비스 방식 (Unsloth 4비트) | 363초 | 504초 | 866초 | 1.0배 |
| vLLM + 캐시, 전체 순서 | 96초 | 106초 | 202초 | 4.3배 |
| vLLM + 캐시, 256쌍씩 재사용 | 99초 | 94초 | 193초 | 4.5배 |
모델이 같은 결과를 내는지도 1만 쌍 전체에서 확인했다.
| 확인 항목 | 결과 |
|---|---|
| 최종 판단 일치 (문턱 0.3) | 98.3% |
| 판단 일치 (문턱 0.5) | 97.5% |
| 문장이 글자까지 같은 비율 | 88% |
3) 서비스 방식과 같은 판단을 하는 모델로
이번에는 순서를 바꿔서 얻은 이득이 202초 에서 193초로 작았다. 앞의 실험에서는 생성 단계가 9,996쌍이었는데, 이번에는 서비스 모델의 판단대로 5,499쌍만 생성했기 때문이다.
순서를 바꿔서 아끼는 건 생성 단계에서 질문을 다시 읽는 시간이라, 생성할 쌍이 적으면 그만큼 이득도 줄어든다. 순서 바꾸기는 생성할 문장이 많을수록 효과가 크다.
4) 정리
“vLLM이었다면 얼마나 빨랐을까”에 대한 답은 이렇다. 실제로 13.5만 쌍을 만든 방식과 같은 판단을 내리면서, 4.5배 빨랐다. 엔진을 바꿔서 2.6배, 이미 읽은 것을 다시 읽지 않게 만들어서 다시 2배였다.
측정의 한계도 밝혀 둔다. 모든 측정은 L4 GPU에서 1만 쌍 표본으로 했고, 실제 13.5만 쌍 생성은 A100에서 했다. GPU가 달라지면 배수도 달라질 수 있다.
그렇다면 처음부터 vLLM을 썼어야 했을까. 학습한 노트북에서 그대로 생성까지 이어 가는 편리함도 분명했다. 몇천 건 정도라면 Hugging Face로도 충분하고, 그 편이 더 빠르게 끝날 수도 있다. 하지만 생성할 건수가 수만 건을 넘어가고 문장이 길어질수록, 생성 전용 엔진으로 옮기는 수고는 충분히 값을 한다. 그리고 옮길 때는 속도보다 먼저, 결과가 같은지를 확인하자.