그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -3-


SFT 모델로 만든 추천사유 13.5만 건, vLLM이었다면 얼마나 빨랐을까
2편에서는 큰 LLM이 쓴 추천사유 1만여 건으로 소형 모델(Gemma 3 4B)을 학습했다. 그리고 호스팅 서버 성능 문제로 SFT 모델로 추천사유가 필요한 13.5만 쌍의 설명을 미리 만들어 데모페이지를 구성했다.
1. 전에 만든 생성 배치 방식은 낭비가 있었다
생성은 두 단계로 나눴다. 이 방식을 이해하려면 모델이 내놓는 답의 모양부터 봐야 한다. 작은 LLM 모델인 학생 모델은 항상 아래 둘 중 하나의 JSON으로 답한다.
{"decision": "write", "text": "쌈배추와 청경채로 따뜻한 샤브샤브 어떠세요?"}
{"decision": "skip"}
{"decision": "까지는 언제나 똑같다. 그래서 이 부분을 미리 붙여서 넘기면, 모델이 처음 만드는 토큰은 write 아니면 skip이 된다. 즉 첫 토큰 하나가 text 를 쓸지 말지의 판단이 된다. 게다가 모델은 이 토큰을 고를 때 “write일 확률 70%, skip일 확률 30%”처럼 확률도 함께 계산한다.
이러한 성질을 이용해서 생성을 아래 그림처럼 두 단계로 나눠봤다.
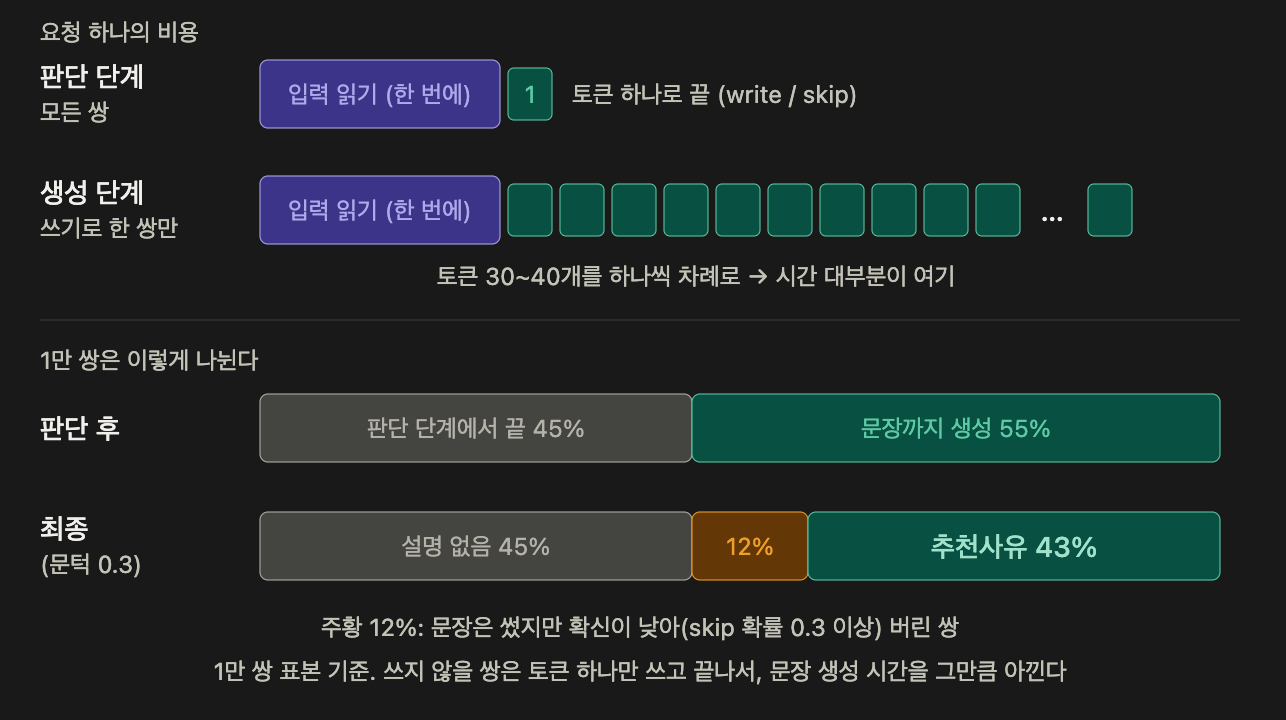
예를 들어 한 쌍은 아래와 같이 근거와 추천 상품을 의미한다. 다시 정리 하면, 모델이 반환하는 결과값에서 {"decision": " 는 추천사유가 붙든 붙지 않든 동일하게 출력이 되고 토큰하나로 "skip" 또는 "write" 가 붙으면서 판단 단계가 끝나게 된다.
| 쌍 (근거 - 추천) | 판단 단계의 skip 확률 | 판단 단계 | 생성 단계 | 최종 (문턱 0.3) |
|---|---|---|---|---|
| 쌈배추 - 청경채 | 0.08 | 쓰는 쪽 | 문장 생성 | 추천사유 붙음 |
| 김장배추 - 달걀 | 0.90 | 쓰지 않는 쪽 | 하지 않음 | 설명 없음 |
위 내용을 다시 예시로 표현해보면 다음과 같다.
[판단 배치]  모든 쌍, 토큰 1개씩

질문 1 (쌈배추 → 청경채)      →  write   (skip 확률 0.08)
질문 2 (김장배추 → 달걀)       →  skip    (skip 확률 0.90)
질문 3 (당근 → 대파)          →  write   (skip 확률 0.40)
질문 4 (삼겹살 → 쌈무)         →  write   (skip 확률 0.05)
질문 5 (허니버터칩 → 오사쯔)    →  skip    (skip 확률 0.85)
질문 6 (순두부 → 바지락)       →  write   (skip 확률 0.12)
[생성 배치] write를 고른 쌍만, 문장 끝까지
질문 1 (쌈배추 → 청경채) → write", "text": "쌈배추와 청경채로 따뜻한 샤브샤브 어떠세요?"}
질문 3 (당근 → 대파) → write", "text": "당근과 대파를 함께 볶으면 볶음밥이 맛있어져요."}
질문 4 (삼겹살 → 쌈무) → write", "text": "삼겹살에는 새콤한 쌈무가 잘 어울려요."}
질문 6 (순두부 → 바지락) → write", "text": "바지락으로 찌개 끓일 때 순두부를 넣으면 시원해요."}[최종]
질문 1 (쌈배추 → 청경채) 0.08 → 추천사유 붙음
질문 2 (김장배추 → 달걀) 0.90 → 설명 없음 (판단 단계에서 끝)
질문 3 (당근 → 대파) 0.40 → 설명 없음 (문장은 썼지만 확신이 낮아 버림)
질문 4 (삼겹살 → 쌈무) 0.05 → 추천사유 붙음
질문 5 (허니버터칩 → 오사쯔) 0.85 → 설명 없음 (판단 단계에서 끝)
질문 6 (순두부 → 바지락) 0.12 → 추천사유 붙음만약 한 번에 생성했다면 다음과 같은 모양이 되지 않았을까
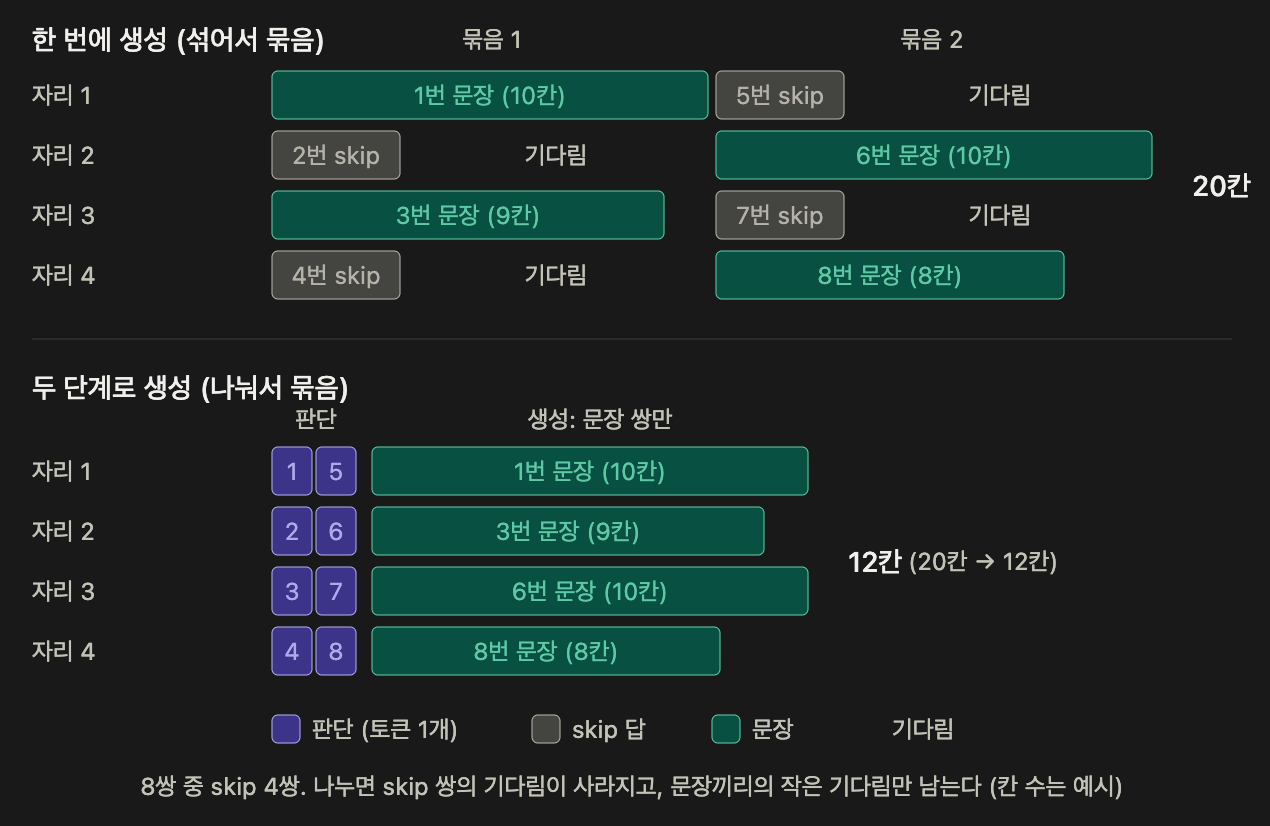
[한 번에 생성하는 배치]  모든 쌍, 문장 끝까지

질문 1 (쌈배추 → 청경채)      →  write", "text": "쌈배추와 청경채로 따뜻한 샤브샤브 어떠세요?"}
질문 2 (김장배추 → 달걀)       →  skip"}        ← 몇 토큰 만에 끝났지만, 다른 문장이 끝날 때까지 대기
질문 3 (당근 → 대파)          →  write", "text": "당근과 대파를 함께 볶으면 볶음밥이 맛있어져요."}
질문 4 (삼겹살 → 쌈무)         →  write", "text": "삼겹살에는 새콤한 쌈무가 잘 어울려요."}
질문 5 (허니버터칩 → 오사쯔)    →  skip"}        ← 대기
질문 6 (순두부 → 바지락)       →  write", "text": "바지락으로 찌개 끓일 때 순두부를 넣으면 시원해요."}
2. vLLM은 이 낭비를 어떻게 푸나
vLLM은 LLM의 추론과 서빙을 위해 만들어진 오픈소스 엔진이다. UC 버클리에서 시작된 프로젝트로 KV 캐시를 운영체제의 가상 메모리처럼 작은 블록으로 나눠 관리하는 PagedAttention이라는 방식을 들고 나왔다. Hugging Face에 올라온 대부분의 모델을 그대로 불러올 수도 있고 API와 같은 형식의 서버로 띄울 수도 있어 서비스용 추론 엔진으로 널리 쓰인다. 여기서는 서버를 띄우지 않고 질문 목록을 한 번에 넘겨 답을 받는 일괄 생성 기능만 썼다.
from vllm import LLM, SamplingParams

llm = LLM(model="학습한 모델 경로")
outputs = llm.generate(prompts, SamplingParams(temperature=0, max_tokens=64))
배치를 어떻게 짤지는 신경 쓰지 않아도 된다. 프롬프트 목록 전체를 한 번에 넘기면 vLLM이 알아서 순서와 자리를 정한다. Unsloth가 학습을 빠르게 하려고 만든 도구라면 vLLM은 처음부터 생성만을 위해 만든 엔진이다. 그래서 앞에서 본 낭비들을 엔진 차원에서 없앤다.
1) 생성 배치
13.5만 쌍의 설명을 만든다는 건, 모델에게 13.5만 개의 질문을 던지는 일이다. 이 질문을 하나씩 처리하지 않고 여러 개를 한꺼번에 넣어 동시에 답을 받는데, 이 단위를 생성 배치라고 부른다. 2편에서는 판단 단계는 32개, 생성 단계는 128개씩 묶었다.
묶는 이유는 GPU의 특성에 있다. 모델이 토큰 하나를 만들때 가장 오래 걸리는 일은 계산이 아니라, 수 GB에 이르는 모델 가중치를 메모리에서 읽어 오는 일이다. 그런데 이 가중치는 질문이 하나든 128개든 한 번만 읽으면 된다. 읽어 온 가중치로 128개 질문의 다음 토큰을 함께 계산하면 되기 때문이다.
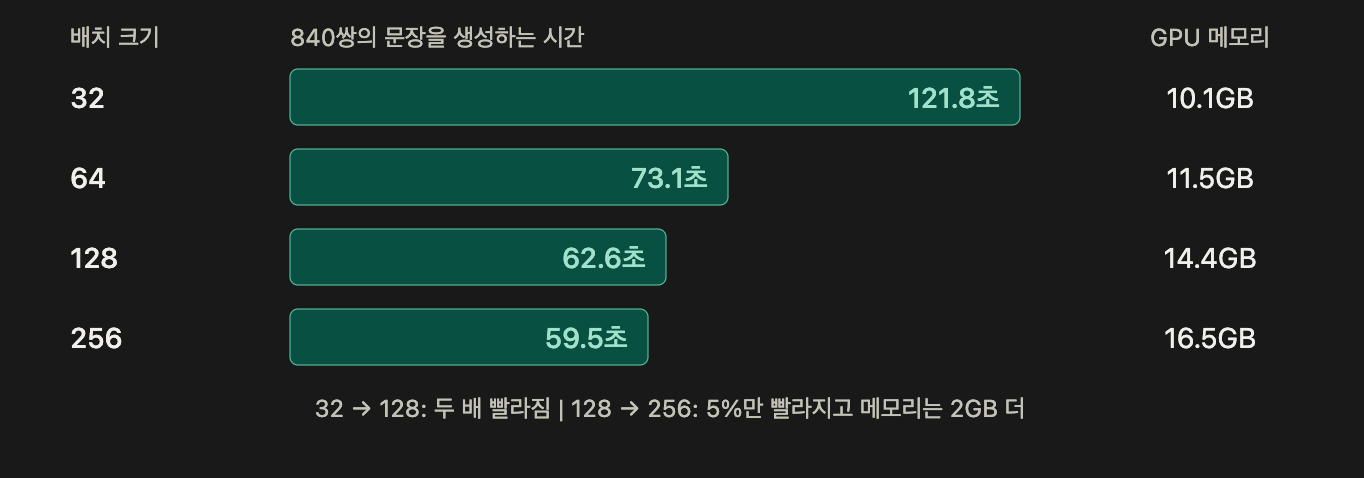
실제로 생성 단계의 배치 크기를 바꿔 가며 재 보면 이 효과가 그대로 드러난다. 아래는 추천사유 생성을 위해 생성배치를 늘려가며 배치 크기와 메모리를 테스트한 결과다.
| 기록 이름 | n | 2단계 쌍 | 판단 배치 | 생성 배치 | 2단계 시간 (write_s) | 최대 메모리 (peak_mem_gb) |
|---|---|---|---|---|---|---|
| B_16bit_gen32 | 2,000 | 840 | 32 | 32 | 121.8초 | 10.1GB |
| B_16bit_gen64 | 2,000 | 840 | 32 | 64 | 73.1초 | 11.5GB |
| B_16bit_gen128 | 2,000 | 840 | 32 | 128 | 62.6초 | 14.4GB |
| B_16bit_gen256 | 2,000 | 840 | 32 | 256 | 59.5초 | 16.5GB |
버스라고 생각해보자. 한 번 운행하는 데 드는 시간은 승객이 한 명이든 128명이든 비슷하니 많이 태울수록 빨리 나를 수 있다. 실제로 생성 단계의 배치 크기를 바꿔 가며 재 보면 이 효과가 그대로 드러난다.
위 표를 보면 배치 크기를 32에서 128로 키우면 두 배 정도 빨라진다. 하지만 128에서 256으로 키우면 5%만 빨라지고 메모리는 2GB 가 더 드는 걸 볼 수 있다. 그런데 128에서 256으로 키우면 5%만 빨라지고 메모리는 2GB가 더 든다.
버스에 비유하면 좌석을 늘리는 데 비용이 들기 시작하는 지점이다. 그 비용이 무엇인지 보려면 모델이 답을 만드는 과정을 조금 들여다봐야 한다.
2) KV 캐시
LLM은 답을 한 번에 쓰지 않는다. 질문을 읽고, 토큰 하나를 만들고 그 토큰까지 포함해 다시 다음 토큰을 만든다. 이때 앞서 읽은 토큰들의 계산 결과를 매번 처음부터 다시 하지 않도록 저장해 두는데, 이것이 KV 캐시다.
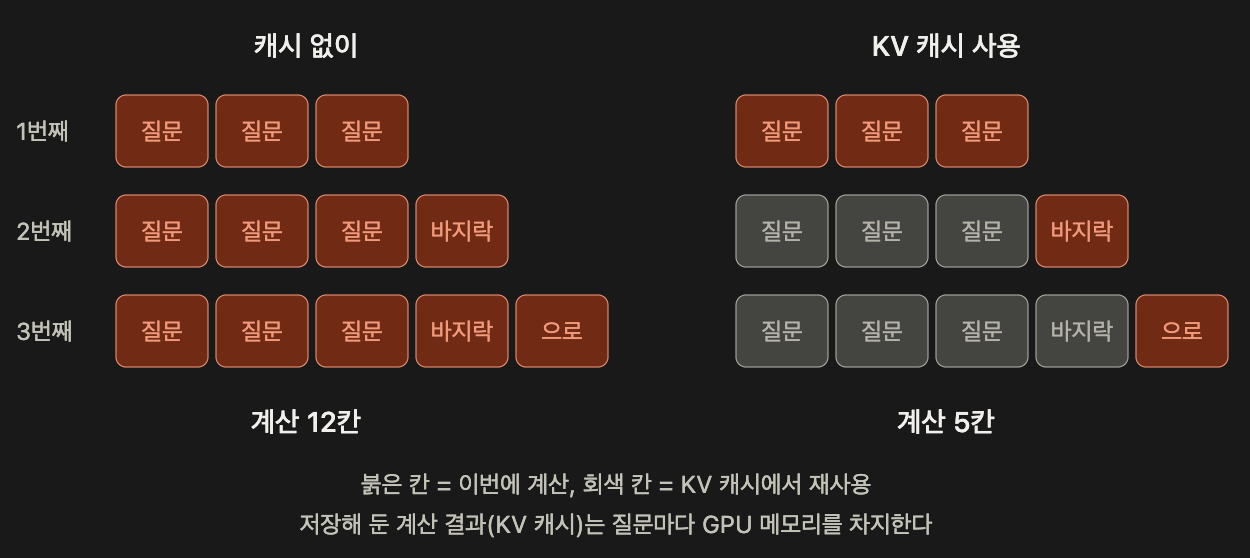
그래서 생성은 두 단계로 나뉜다. 질문 전체를 한 번에 읽는 단계(prefill)와, 답을 한 토큰씩 차례로 쓰는 단계(decode)다. 시험에 비유하면 문제는 한눈에 훑어보지만 답은 한 글자씩 써야 하는 것과 같다.
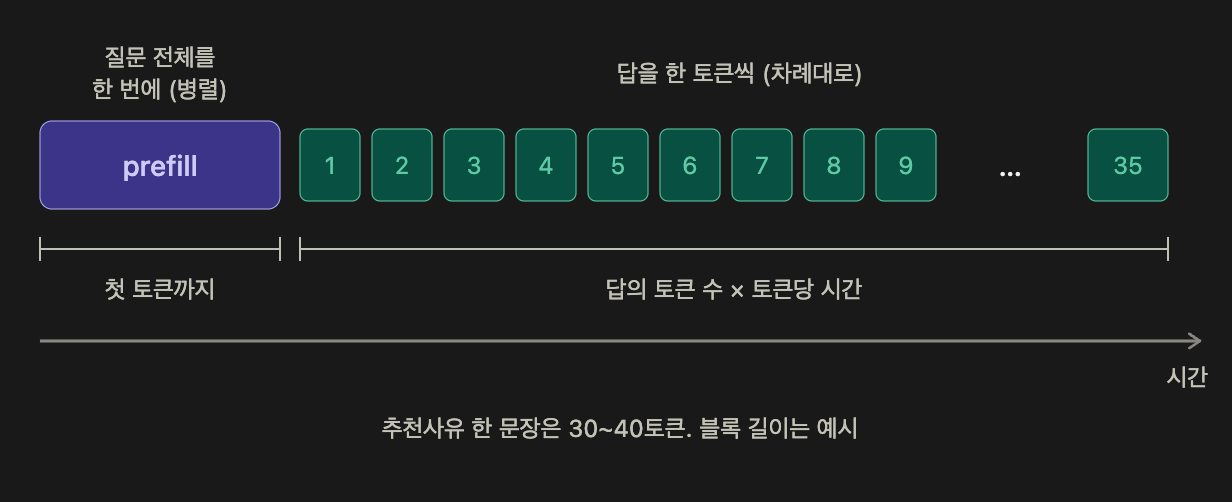
KV 캐시는 질문마다 GPU 메모리를 차지한다. 배치를 키울수록 동시에 들고 있어야 할 KV 캐시가 늘어나니, 배치 크기의 한계는 결국 KV 캐시가 메모리에 얼마나 들어가느냐로 정해진다. 배치를 키울 때마다 메모리가 늘어난 이유가 이것이다.
3) 묶으면 생기는 낭비
배치는 버스처럼 다 같이 출발하고 다 같이 도착한다. 여기서 두 가지 낭비가 생긴다.
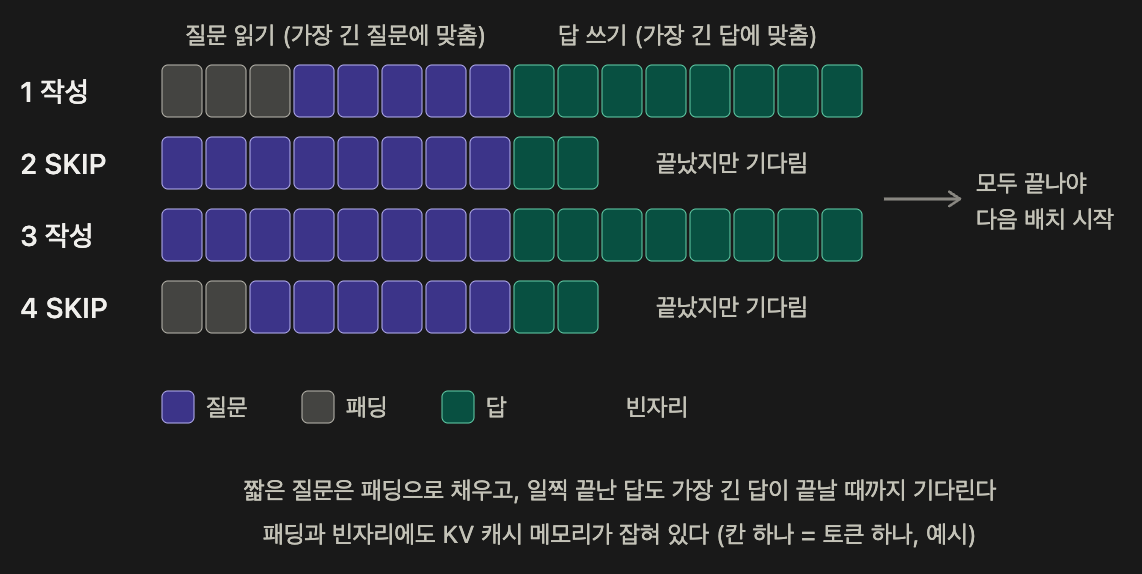
첫째, 패딩이다. 질문마다 길이가 달라서, 짧은 질문 앞을 빈칸으로 채워 길이를 맞춘다. 빈칸도 계산하고 KV 캐시 메모리도 차지한다.
둘째, 기다림이다. 배치 안에서 가장 긴 답이 끝날 때까지 모두가 기다린다. 짧은 답은 일찍 끝나도 자리를 비우지 못한다.
위에서 나눈 판단, 생성으로 나눈 2단계 생성은 사실 이 기다림을 줄이려는 방법이었다. 판단과 생성을 한 배치에서 하면, 몇 토큰 만에 끝나는 skip 답이 30~40토큰짜리 문장이 끝날 때까지 자리를 차지한다. 판단을 따로 하면 그 배치는 모두 토큰 하나로 끝나고, 생성 배치에는 문장을 쓸 질문만 모인다.
하지만 이것만으로는 부족했다. 문장끼리도 길이가 20토큰에서 50토큰 넘게까지 달라서, 생성 배치 안에서도 짧은 문장은 긴 문장을 기다린다. 배치 크기는 메모리에 맞춰 128로 고정되어 있고 모든 질문이 똑같이 시작하는 지시문도 매번 다시 읽는다.
4) vLLM은 어떻게 푸나
vLLM은 생성 전용 엔진답게 이 낭비들을 엔진 차원에서 없앤다.
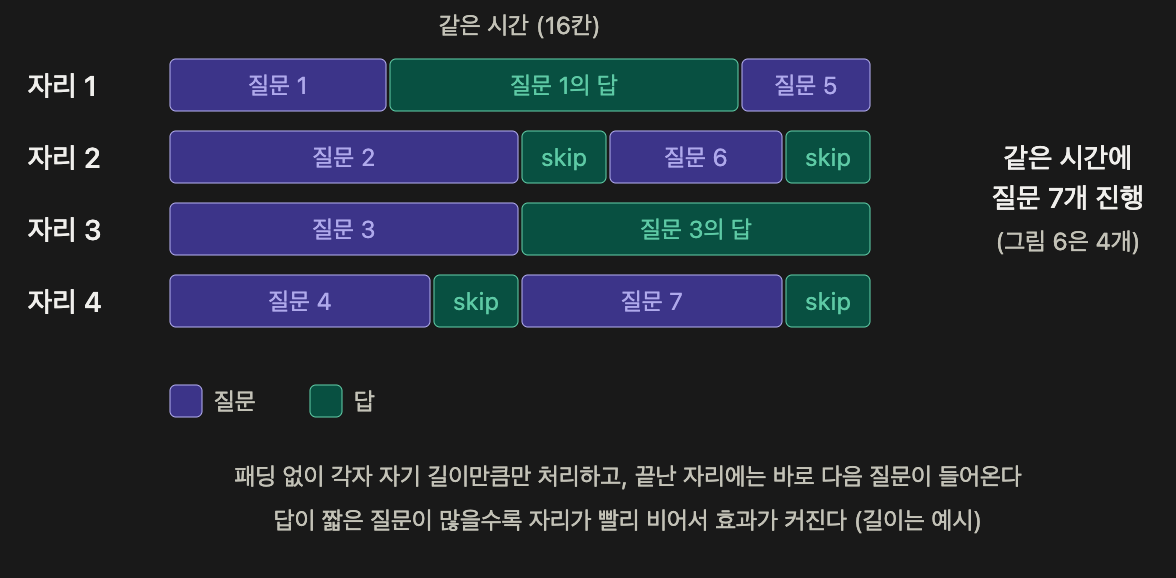
a. 끝난 자리에 바로 다음 질문을 넣는다.
배치가 통째로 끝나기를 기다리지 않고, 답이 끝난 질문의 자리에 곧바로 다음 질문을 넣는다. 승객이 내리는 즉시 그 자리에 다음 승객을 태우는 버스인 셈이다. 이걸 연속 배칭이라고 부른다.
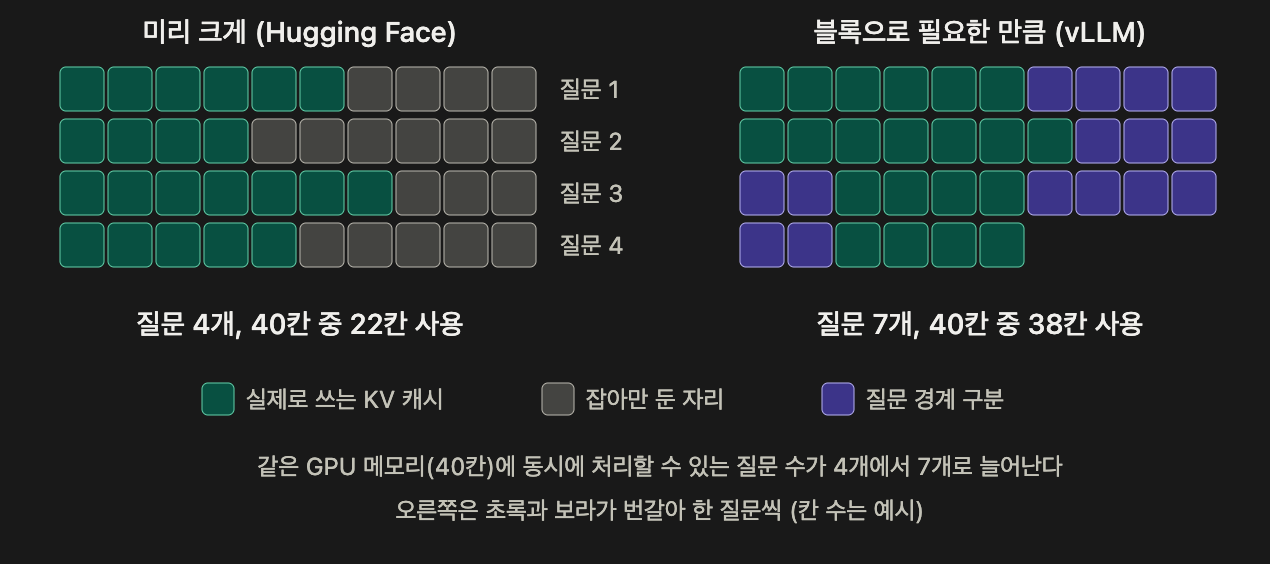
b. KV 캐시를 필요한 만큼만 쓴다.
질문마다 최대 길이만큼 메모리를 미리 잡아 두지 않고, KV 캐시를 작은 블록으로 나눠 실제로 쓰는 만큼만 가져다 쓴다. 남는 메모리가 없으니 같은 GPU에서 훨씬 많은 질문을 동시에 처리한다. 실험한 L4에서 vLLM은 KV 캐시로 6.5만 토큰을 잡았는데 질문 하나가 150~200토큰이니 수백 개를 동시에 들고 있을 수 있다.
c. 같은 앞부분은 한 번만 읽는다.
모든 질문이 똑같은 지시문으로 시작한다면, 그 부분의 KV 캐시를 한 번만 만들고 나머지 질문이 재사용하게 할 수 있다.
그렇다면 실제로 얼마나 빨라질까. 비교에 앞서 확인해야 할 것이 하나 있었다.
3. 두 엔진 차이를 보기 위한 조건
속도를 비교하려면 두 방식이 같은 일을 해야 한다. 같은 질문에 같은 판단을 내리고 같은 양의 문장을 써야 시간 차이를 엔진의 차이로 볼 수 있다.
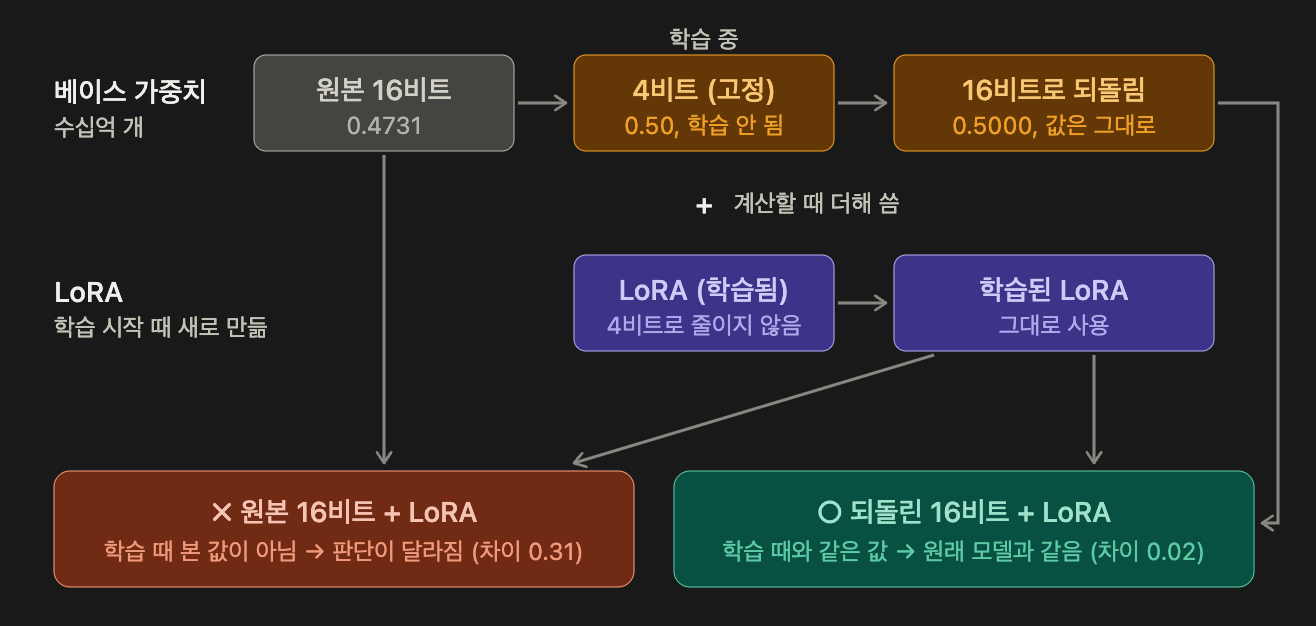
vLLM에 올리려면 학습한 LoRA를 베이스 모델 (Gemma 3 4B의 원본 가중치는 16비트) 에 합쳐 하나의 16비트 모델로 만들어야 한다. 그런데 합친 모델로 돌려 보니 오류 없이 판단만 달라져 있었다. 같은 질문에서 skip 확률이 평균 0.31이나 차이 났다.
원인은 학습 방식에 있었다. 모델은 4비트로 줄인 가중치 위에서 학습했는데, 합칠 때는 줄이기 전의 원본 16비트 가중치에 LoRA를 붙였다. LoRA는 4비트로 반올림된 가중치에 맞춰 학습됐으니 원래 가중치에 붙이면 다르게 동작할 수밖에 없었다.
4. 엔진을 바꾸니 문장이 길수록 차이가 커진다
엔진의 차이만 보기 위해, 같은 16비트 모델을 Hugging Face와 vLLM으로 각각 돌렸다.
비교 조건은 이렇게 맞췄다.
- 13.5만 쌍에서 무작위로 뽑은 1만 쌍, GPU는 L4
- 판단 단계는 1만 쌍 전부, 생성 단계는 같은 9,996쌍 목록으로 고정
- 둘 다 같은 질문, 같은 최대 길이(64토큰), 확률이 가장 높은 토큰만 고르는 방식(greedy)
- 모델을 불러오는 시간은 빼고, 생성에 걸린 시간만 측정
먼저 두 엔진이 정말 같은 일을 했는지 확인했다.
| 확인 항목 | 결과 |
|---|---|
| 판단 일치 | 99.9% |
| 생성한 토큰 수 | 333,757 vs 334,411 (차이 0.2%) |
| 문장이 글자까지 같은 비율 | 77% |
판단과 일의 양이 같으니 시간 차이는 엔진의 차이로 볼 수 있다. 문장이 23% 다른 건 정상이다. 같은 모델이라도 엔진마다 계산 순서가 달라 소수점 끝자리가 조금씩 다르고, 확률이 거의 같은 두 토큰 사이에서 다른 쪽을 고르면 그 뒤 문장이 갈라진다.
결과는 이랬다.
| Hugging Face | vLLM | 차이 | |
|---|---|---|---|
| 판단 단계 (1만 쌍, 토큰 1개) | 325초 | 211초 | 1.5배 |
| 생성 단계 (9,996쌍, 문장) | 1,074초 | 327초 | 3.3배 |
| 전체 | 1,400초 | 538초 | 2.6배 |
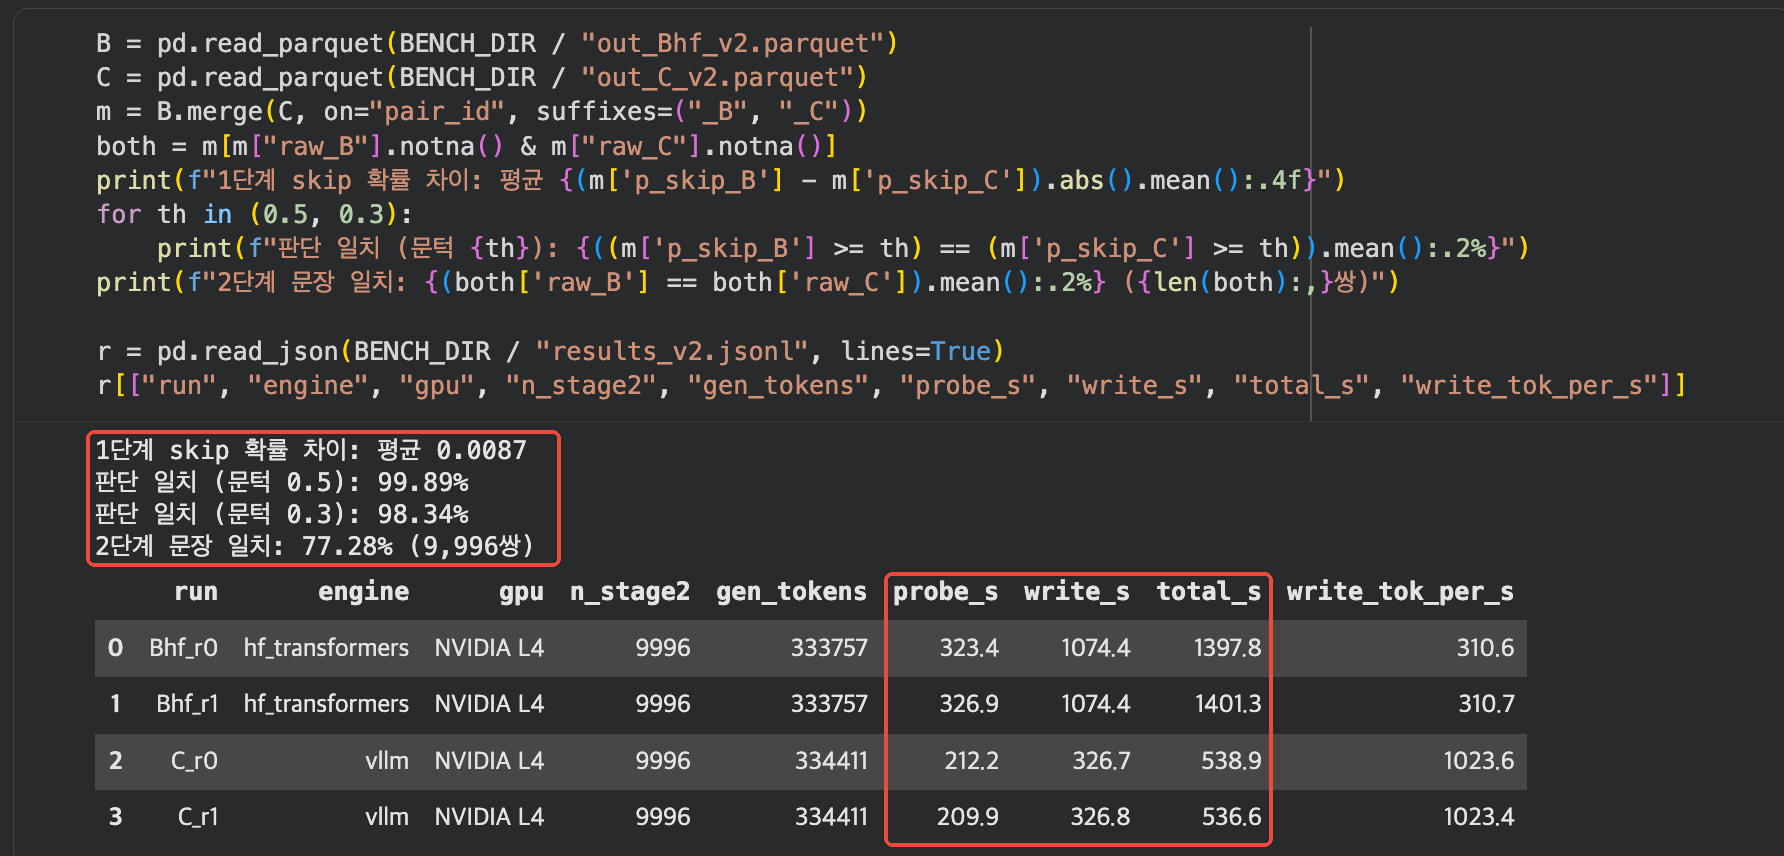
probe_s(판단 단계), write_s(생성 단계), total_s(전체)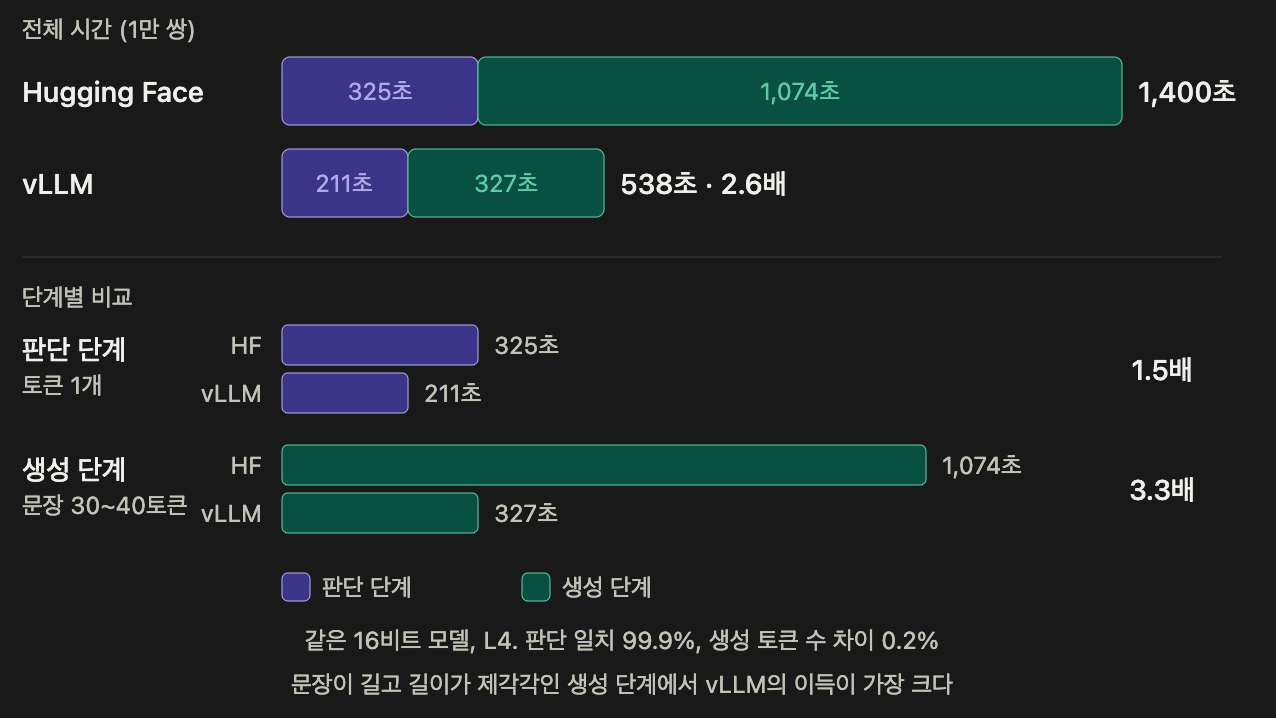
엔진만 바꿨는데 전체가 2.6배 빨라졌다. 차이는 생성 단계에서 특히 컸다.
문장은 20토큰에서 50토큰 넘게까지 길이가 제각각이라, Hugging Face의 배치에서는 짧은 문장이 긴 문장을 기다리는 시간이 길어진다.
vLLM은 끝난 자리에 바로 다음 질문을 넣으니 그 낭비가 없다. 게다가 KV 캐시를 필요한 만큼만 써서 한 번에 처리하는 질문도 훨씬 많다.
문장이 길수록, 그리고 길이가 제각각일수록 차이가 커진다.
판단 단계는 모든 질문이 토큰 하나로 끝나서 기다림이 없는데도 1.5배 빨랐다. 이 차이는 토큰을 만들 때마다 드는 부담을 줄이는 vLLM의 최적화에서 온다. vLLM은 GPU에 내리는 작업을 미리 녹화해 두고 한 번에 재생하는 방식(CUDA 그래프)과, 생성에 맞게 다듬은 계산 코드를 쓴다.
다만 vLLM은 모델을 불러오고 준비하는 데 5분 남짓 걸렸다. 1만 쌍처럼 작은 작업에서는 이 시간이 이득의 상당 부분을 깎는다. 13.5만 쌍 규모라면 무시할 만하다고 생각한다.