ai / ml

A collection of 14 posts
그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -4-
ai / ml

그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -4-

SFT 모델로 만든 추천사유 13.5만 건, 기존 서비스 방식보다 4.5배 더 빠르게 이전 포스트에서는 Hugging Face로 만들던 추천사유를 vLLM으로 바꿔 봤다. 같은 모델에 같은 일을 시키고 엔진만 바꿨는데 전체가 2.6배 빨라졌다. 특히 문장을 쓰는 생성 단계에서 차이가 컸는데 짧은 문장이 긴 문장을 기다리는 낭비를 vLLM이 없애 주었기
14 min read
그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -3-
ai / ml

그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -3-

SFT 모델로 만든 추천사유 13.5만 건, vLLM이었다면 얼마나 빨랐을까 2편에서는 큰 LLM이 쓴 추천사유 1만여 건으로 소형 모델(Gemma 3 4B)을 학습했다. 그리고 호스팅 서버 성능 문제로, 추천사유가 필요한 13.5만 쌍의 설명을 SFT 모델로 미리 만들어 데모페이지를 구성했다. 1. 판단과 생성, 두 단계로 나눈 생성 방식 생성은
15 min read
그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -2-
ai / ml

그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -2-

SFT 로 추천사유 만들기 지난 포스트에서는 "이 요리에 필요한 재료" 라는 컨셉으로 간단한 추천모델을 만들었다. 이제 추천에 이유를 붙여보자. 된장찌개 재료를 담은 고객에게 대파를 그냥 보여주는 것과, "된장찌개 끓일때 두부에 대파를 넣어 보세요" 라는 한 줄을 붙여 보여주는 것은 다르다. 1편에서도 얘기했지만, 이유가 붙으면 고객은 그
27 min read
그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -1-
ai / ml

그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -1-

왜 추천사유인가 장을 볼 때 우리는 보통 어떤 방식으로 상품을 고르는지 떠올려봤다. 대부분은 "오늘 저녁은 된장찌개" 처럼 메뉴를 먼저 떠올리고, 필요한 재료를 담은 다음 떨어질 때가 된 우유나 계란을 같이 챙길 것이다. 그런데 대부분의 추천 영역은 이런 맥락이 없이 상품만 나열하곤 한다. 고객입장에서는 왜 이 상품이 나왔는지 알
27 min read
LoRA 에 대한 이야기 그리고 지난 실험에서 결합이 충돌한 이유
ai / ml

LoRA 에 대한 이야기 그리고 지난 실험에서 결합이 충돌한 이유

들어가며 지난 포스트에서는 부산 사투리를 배운 캐릭터 LoRA 와 의료 상담을 배운 LoRA 를 합쳐 보는 실험을 했다. 이번 글에서는 한 걸음 물러서서, LoRA가 실제로 무엇을 학습하는지 정리해 본다. 수식은 최소한으로 쓰고, 곱셈표 하나로 설명해 보려고 한다. 01.모델은 거대한 숫자 표다 언어모델 안에는 글자도 문법 규칙도 없다. 가중치 행렬(
9 min read
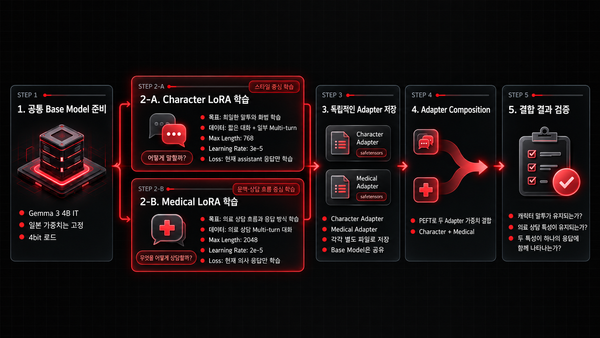
Gemma 3 LoRA Adapter Composition 실험 - 1
ai / ml

Gemma 3 LoRA Adapter Composition 실험 - 1

두 개의 LoRA 로 범죄와의 전쟁, 최민식 배우님 캐릭터에 의료 전문성을 더하는 테스트 01.실험의 출발점 하나의 LLM 을 여러 업무에 활용하려면 업무별로 모델을 파인튜닝하는 방법을 생각할 수 있는데 별도의 모델을 하나 하나 배포하고 운영하는게 비효율적일 수 있다. 그래서 vLLM 은 요청별로 하나의 Base 모델에 연결된 서로 다른 Adapter 지정과
22 min read
KcBERT 와 파인튜닝으로 멀티라벨 악플 분류 모델 만들기
ai / ml

KcBERT 와 파인튜닝으로 멀티라벨 악플 분류 모델 만들기

지난 포스트에 이어서 "한국어 혐오표현 데이터셋" 을 가지고, 문장이 어떤 종류의 혐오를 담고 있는지 BERT 모델 기반으로 파인튜닝하고 최적화 하는 과정을 학습차원에서 정리 해보고자 한다. GitHub - smilegate-ai/korean_unsmile_datasetContribute to smilegate-ai/korean_unsmile_dataset development by creating an account on GitHub.GitHubsmilegate-ai 1. 모델에 대하여 1)
7 min read
Vector DB로 ChatGPT 보정하기 (feat. OpenAI)
ai / ml

Vector DB로 ChatGPT 보정하기 (feat. OpenAI)

Vector DB를 알아보다가 간단하게 OpenAI 에서 부족한 정보를 Vector DB를 통해 보완하는 과정을 남겨본다. 1. Vector DB에 대한 소개 1) Vector 일반적으로 벡터는 크기와 방향을 가지고 있는 수치를 나타내는 개념으로 다양한 분야에서 중요한 개념으로 사용된다. 2) Vector Embedding Vector Embedding은 단어나 문장 또는 이미지, 동영상등 다양한 형태의 특징 데이터를 추출해서
8 min read