그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -2-


SFT 로 추천사유 만들기
지난 포스트에서는 "이 요리에 필요한 재료" 라는 컨셉으로 간단한 추천모델을 만들었다.
이제 추천에 이유를 붙여보자. 추천상품에 "왜" 를 붙여서 된장찌개 재료를 담은 고객에게 대파를 그냥 보여주는 것과, "된장찌개 끓일때 두부에 대파을 넣어 보세요" 라는 한 줄을 붙여 보여주는 것은 다르다. 이유가 붙으면 추천이 장바구니를 이해하고 있다는 신호가 되고 고갹은 그 상품이 지금 필요한지 바로 판단할 수 있다.
아마도 가장 쉬운방법은 LLM 에게 장바구니와 추천상품을 보여주고 이유를 써달라고 하는 것이다. 하지만 비용과 속도도 문제고 품질도 들쭉날쭉 할 것이고 프롬프트만으로는 문장 길이, 말투, 금지 표현을 매번 지키게 만들기가 어렵다. 그리고 LLM 은 이유를 어떻게서든 지어낼 것이다. 실제 추천 근거와 동떨어진 추천 사유를 만들지도 모르는 일이다.
1. 근거 만들기
LLM에게 "왜 이 상품을 추천했는지"를 쓰게 하려면, 먼저 그 이유를 데이터에서 꺼내야 한다. 추천 점수를 기반으로 근거 상품을 찾고, 그 근거를 설명에 써도 되는지 판정해서 LLM이 받을 입력을 만들어본다.
1) 점수가 곧 근거
1편에서 본 것처럼 EASE의 추천 점수는 장바구니에 담긴 상품들의 점수표 값을 더한 것이다. 더하기로만 만들어지기 때문에 "어떤 장바구니 상품이 얼마나 기여했는지" 로 그대로 나눌 수 있다.
실제로 삼겹살과 양상추를 담은 장바구니에서는 목심이 1위로 추천된다. 이 추천 점수를 장바구니 상품별로 나눠 보면, 점수를 끌어올린 몫의 97%가 삼겹살에서, 나머지가 양상추에서 나온다. 목심은 사실상 삼겹살 때문에 추천된 것이다.
"점수가 어디서 나왔나"와 "설명의 이유로 써도 되나"는 다른 문제다. 삼겹살과 목심은 함께 요리하는 짝이라기보다 둘 중 하나를 고르는 관계라서, 다음 규칙에서는 이 추천에 설명을 붙이지 않는다.
2) 근거를 고르는 규칙
기여도가 가장 큰 상품을 그대로 근거로 쓰면 될 것 같지만, 실제로는 어색한 근거가 섞인다. 기여도는 "점수에 얼마나 보탰나"일 뿐, 위에서 삼겹살과 목심의 관계처럼 기여도가 97%여도 둘 중 하나를 고르는 관계 일 수 있다. 그래서 설명에 써도 되는 장바구니 상품만 후보로 남기는 규칙을 두었다.
판정에는 lift를 썼다. lift는 두 상품이 우연히 같이 담길 때보다 몇 배 자주 함께 담기는지를 나타낸다.
              a와 b가 함께 담긴 장바구니 수 × 전체 장바구니 수
lift(a, b) = ─────────────────────────────────────────────
                a가 담긴 장바구니 수 × b가 담긴 장바구니 수
lift가 3이면 두 상품은 우연보다 3배 자주 같은 장바구니에 담긴다. 근거 후보는 아래 규칙을 모두 통과한 장바구니 상품이고, 그중 기여도가 가장 큰 상품을 근거로 고른다.
| 규칙 | 예외 |
|---|---|
| 학습 장바구니에서 함께 담긴 횟수가 100번 이상 | 몇 번 우연히 같이 팔린 쌍 |
| lift 2.0 이상 | 같이 담기긴 해도 우연과 큰 차이가 없는 약한 관계 |
| 둘 중 하나가 흔한 상품(장바구니의 4% 이상에 담김)이면 lift 3.0 이상 | 달걀·우유처럼 어디에나 담기는 상품이 아무 추천에나 근거로 붙는 경우 (흔한 상품도 기준을 넘으면 근거가 될 수 있음) |
| 장바구니 상품들이 추천 점수를 끌어올린 몫 중 근거 상품의 몫이 10% 이상 | 추천은 사실상 다른 상품이 만들었는데, 기준만 넘은 상품이 근거로 붙는 경우 |
| 근거와 추천 상품이 같은 종류나 같은 브랜드가 아님 (같은 중분류, 또는 만두와 돈까스·고등어와 삼겹살처럼 미리 묶어 둔 종류) |
칸타타 디카페인과 칸타타 블랙, 삼겹살과 목심처럼 함께 쓰기보다 둘 중 하나를 고르는 상품 |
| 근거 상품이 요리 재료 | 과자·음료가 요리의 이유로 붙는 경우 |
처음에는 lift가 높을수록 좋은 근거라고 봤는데 lift가 100을 넘는 쌍은 대부분 칸타타 디카페인과 칸타타 블랙처럼 같은 라인의 다른 맛 상품이었다.
아주 높은 lift는 보완 관계가 아니라 고르는 관계의 신호였고 그래서 같은 종류와 같은 브랜드를 제외하는 규칙을 더했다.
3) 근거 묶음
추천 하나마다 근거를 한 묶음으로 모은다. 떡볶이떡을 담은 장바구니에 어묵을 추천하는 케이스는 이렇다.
{
  "reason_type": "보완형",
  "recommended_item": "사조대림 초특가 얇은 사각어묵 240G*2",
  "recommended_scate": "어묵",
  "basket": ["풀무원 밀 떡볶이떡 550G", "농협목우촌 주부9단 비엔나 250G*2",
             "사조대림 닭가슴살 블랙페퍼 100G", "풀무원 생만두 고기배추 400G"],
  "evidence": {"reason_item": "풀무원 밀 떡볶이떡 550G",
               "reason_share": 0.85, "pair_count": 3013, "lift": 10.96}
}| 필드 | 의미 | 문장에 쓰나 |
|---|---|---|
| recommended_item, recommended_scate | 추천 상품과 소분류 | 상품명을 줄여서 씀 |
| basket | 장바구니 상품 목록 (첫 번째가 근거 상품) | 상황 파악에만 씀 |
| reason_item | 근거 상품 | 반드시 이유로 씀 |
| reason_share | 추천 점수 중 근거 상품의 기여 비율 | 쓰지 않음 (판단용) |
| pair_count, lift | 근거의 강도 | 쓰지 않음 (판단용) |
이 묶음이 이 작업의 핵심이다. 무엇을 추천할지 어떤 이유를 말할지는 여기서 모두 정해진다.
LLM은 "바지락 때문에 순두부를 추천했다"는 사실을 받아 "바지락으로 찌개 끓일 때 순두부를 넣으면 시원해요" 같은 문장으로 옮기기만 한다.
이유를 지어낼 여지가 없으니 환각을 통제할 수 있고, 문제가 생기면 근거 단계의 문제인지 문장 단계의 문제인지 바로 구분할 수 있다.
이번에는 장바구니 상품과의 관계를 근거로 하는 보완형만 다뤘다. 고객이 전에 자주 산 상품을 근거로 하는 재구매형은 고객을 식별해야 판정할 수 있는데 데모에서는 로그인 고객을 알 수 없어 제외하기로 했다.
2. 큰 모델로 학습 데이터 만들기
근거 묶음이 준비됐으니, 이제 이 묶음을 문장으로 옮길 차례다. 이 일을 처음 맡는 건 큰 LLM이고, 큰 모델이 쓴 문장이 나중에 소형 모델의 학습 데이터가 된다.
1) 규칙 정하기
프롬프트의 첫 문단에 이 작업의 성격을 못 박았다.
추천 상품과 추천 이유(근거 상품)는 이미 정해져 있습니다. 당신은 주어진 근거를 문장으로 옮기기만 합니다. 새로운 이유를 지어내지 마세요.
LLM은 "왜 추천했는지"를 판단하지 않고, 근거 묶음의 reason_item을 반드시 이유로 든다. 두 상품으로 만드는 대표 요리가 분명하지 않으면 요리 이름을 지어내지 않고 "국이나 찌개에"처럼 넓게 쓰거나 쓰지 않는다.
장바구니의 다른 상품은 상황을 파악하는 데만 쓰고 문장에 넣지 않는다. 예를 들어 김장배추와 쪽파가 함께 담겨 있으면 "김장 준비라면"처럼 맥락을 읽는 데는 쓰지만, 쪽파를 이유로 들지는 않는다. lift나 동시구매 수 같은 숫자도 근거가 얼마나 강한지 판단하는 데만 참고하고 문장에는 쓰지 않는다.
출력은 JSON 한 개로 고정했다. 문장을 쓰거나, 쓰지 않거나 둘 중 하나다.
{"decision": "write", "text": "떡과 어묵으로 매콤한 떡볶이 어떠세요?"}
{"decision": "skip", "skip_reason": "흔한 채소끼리일 뿐 함께 쓰는 요리가 바로 떠오르지 않음"}
skip_reason은 사람이 큰 LLM의 판단을 검토할 때만 보는 메모로 고객 화면에도 소형 모델의 학습 데이터에도 들어가지 않는다.
2) 억지 설명은 설명이 없는 것보다 나쁘다
규칙을 통과한 근거라도 막상 문장으로 옮기려고 하면 할 말이 없는 경우가 있다. 데이터로는 함께 많이 담기지만, 둘을 함께 쓰는 요리가 딱히 떠오르지 않는 쌍이다. 이런 쌍에 억지로 문장을 쓰면 "단호박과 양배추를 함께 쓰기 좋아요"처럼 아무 정보도 없는 설명이 나오게 된다. 그래서 LLM에게 쓰지 않을 권리를 주고, 언제 쓰지 말아야 하는지를 구체적으로 적었다.
| SKIP 조건 | 예 |
|---|---|
| 두 상품을 함께 쓰는 요리가 바로 떠오르지 않을 때 | 고구마 - 소고기 부채살, 생굴 - 감자 |
| 흔한 채소끼리 장을 같이 본 것일 뿐일 때 | 시금치 - 애호박, 오이 - 청경채 |
| 같은 종류라서 하나를 고르는 관계일 때 | 만두 - 돈까스, 현미 - 혼합곡 |
| 추천 상품이 요리 재료로 보기 어려울 때 | (추천이 이미 재료 영역으로 좁혀져 있어 드물게만 걸리는 안전장치) |
가장 판단이 어려운 건 채소끼리의 쌍이다. 시금치와 애호박은 "둘 다 나물로 무쳐 비빔밥에 올린다"고 쓸 수도 있지만, 이건 각자 따로 쓰는 쓰임을 이어 붙인 것이지 함께 쓰는 쓰임이 아니다. 그래서 이런 경우는 SKIP으로 정했다. 반대로 전골이나 샤브샤브처럼 채소와 버섯을 한 냄비에 넣는 쓰임이 분명하면 쓰도록 경계를 적어두었다.
SKIP도 학습 데이터에서 버리지 않는다. 작은 모델이 "언제 쓰지 말아야 하는지"까지 배워야 하기 때문이다.
3) 문장 규칙
나머지 규칙은 고객 화면에 바로 나가도 되는 문장을 만들기 위한 것이다.
길이와 말투
: 1~2문장, 공백 포함 50자 이내, 해요체. 추천 카드 아래 한두 줄에 들어가는 분량이다.
상품명 줄이기
: "평창 고랭지 대파(봉)"은 "대파"로, "한돈 암퇘지 삼겹살 100G/돼지고기"는 "삼겹살"로 쓴다. 브랜드, 용량, 원산지, 괄호 표기는 쓰지 않는다.
완제품과 양념
: 이미 조리된 상품이나 양념은 그 상태에 맞게 쓴다. "순살 코다리조림"처럼 조리된 상품은 "데워 드실 때", "곁들이면"처럼 쓰고, "닭볶음탕 양념"처럼 양념인 상품은 "이 양념으로"처럼 쓴다.
같은 단어 반복 금지
: "닭볶음탕 양념으로 푸짐한 닭볶음탕을"처럼 한 문장 안에서 같은 단어를 되풀이하지 않는다.
시작 형태 다양화
: 같은 틀이 반복되면 수천 건의 학습 데이터가 한 문장 틀로 쏠리고, 작은 모델도 그 틀만 배운다. 그래서 여섯 가지 시작 형태를 고르게 섞고, 같은 형태를 연달아 쓰지 않도록 했다.
| 형태 | 예 |
|---|---|
| ○○에는 △△가 잘 어울려요 | 삼겹살에는 새콤한 쌈무가 잘 어울려요. |
| ○○ 요리라면 △△도 챙겨 보세요 | 어묵 요리라면 떡볶이떡도 챙겨 보세요. |
| △△를 더하면 ○○로 □□를 만들 수 있어요 | 국거리 소고기를 더하면 미역으로 든든한 미역국을 끓일 수 있어요. |
| ○○과 △△로 □□ 어떠세요? | 동태와 무로 시원한 동태탕 어떠세요? |
| □□ 끓일 때 ○○에 △△를 넣어 보세요 | 순두부찌개 끓일 때 순두부에 이 양념만 더하면 간편해요. |
| ○○을 담으셨네요 (가끔만) | 주꾸미볶음을 담으셨네요. 남은 양념에 밥과 김가루를 넣어 볶아 보세요. |
4) 학습데이터를 만드는 최종 프롬프트
당신은 대형마트 장보기 앱에서 추천 상품 아래에 붙는 한 줄 설명을 쓰는 카피라이터입니다.
고객이 장바구니에 담은 상품을 보고 함께 쓰면 좋은 요리 재료를 추천했고, 그 이유를 짧고 자연스럽게 알려 주는 것이 목표입니다.

추천 상품과 추천 이유(근거 상품)는 이미 정해져 있습니다. 당신은 주어진 근거를 문장으로 옮기기만 합니다.
새로운 이유를 지어내지 마세요.

## 입력
JSON 한 건이 주어집니다.
- reason_type: 항상 "보완형"입니다. 장바구니의 근거 상품과 함께 쓰기 좋아서 추천했다는 뜻입니다.
- recommended_item: 추천 상품명 (브랜드·용량·포장 표기가 붙어 있음)
- recommended_scate: 추천 상품의 소분류
- basket: 고객 장바구니 상품 목록 (첫 번째가 근거 상품)
- evidence
  - reason_item: 근거 상품. 이 상품 때문에 추천했습니다.
  - reason_share, pair_count, lift: 근거가 얼마나 강한지 보여 주는 참고 숫자입니다. SKIP을 판단할 때만 참고하고 문장에는 쓰지 않습니다.

## 쓰는 규칙
1. 1~2문장, 공백 포함 50자 이내, 해요체로 씁니다.
2. 반드시 reason_item을 이유로 들고, 두 상품을 어떻게 함께 쓰는지 한국 가정 요리에서 누구나 아는 쓰임으로 말합니다.
   - 예: 삼겹살과 상추 → 쌈, 떡볶이떡과 어묵 → 떡볶이, 미역과 소고기 → 미역국
   - 두 상품으로 만드는 대표 요리가 분명하지 않으면 요리명을 지어내지 말고 "국이나 찌개에", "볶음에"처럼 넓게 쓰거나 SKIP합니다.
3. 상품명은 고객이 부르는 이름으로 줄입니다.
   - 예: "평창 고랭지 대파(봉)" → "대파", "한돈 암퇘지 삼겹살 100G/돼지고기" → "삼겹살", "동물복지 유정란 10개입" → "달걀"
   - 브랜드, 용량, 원산지, 괄호 표기는 쓰지 않습니다.
4. 상품이 이미 완성된 요리이거나 양념이면 그 상태에 맞게 씁니다.
   - 예: "순살 코다리조림"은 조리된 상품이므로 "데워 드실 때", "곁들이면"처럼 씁니다.
   - 예: "닭볶음탕 양념"은 양념이므로 "이 양념으로"처럼 씁니다.
5. basket의 다른 상품은 상황을 파악하는 데만 씁니다.
   - 예: 김장배추와 쪽파가 함께 있으면 김장 장보기로 읽습니다.
   - 다른 상품의 이름을 문장에 넣거나 이유로 들지 마세요.
6. 문장 첫머리를 다양하게 씁니다. 아래 형태를 고르게 섞고, 같은 형태를 연달아 쓰지 마세요.
   - "○○에는 △△가 잘 어울려요."
   - "○○ 요리라면 △△도 챙겨 보세요."
   - "△△를 더하면 ○○로 □□를 만들 수 있어요."
   - "○○과 △△로 □□ 어떠세요?"
   - "□□ 끓일 때 ○○에 △△를 넣어 보세요."
   - "○○을 담으셨네요. …" (가끔만)
7. 한 문장 안에 같은 단어를 반복하지 않습니다.
   - 나쁜 예: "닭볶음탕 양념으로 푸짐한 닭볶음탕을"

## 쓰지 말아야 할 것
- lift, 동시구매 수, 비율 같은 숫자와 "다른 고객들이 많이 샀어요" 같은 통계 표현
- 품질·신선도를 단정하는 말 ("싱싱한", "신선한", "최상급", "엄선한")
  - 맛과 식감 표현("고소한", "시원한", "아삭한", "매콤한")은 괜찮습니다.
- 가격, 할인, 재고, 산지 자랑, 건강·효능 주장
- 과장 ("꼭", "필수", "최고의"), 이모지, 느낌표
- 고객의 상황을 단정하는 말 ("김장하시는군요"). 대신 "김장 준비라면"처럼 가정형으로 씁니다.

## SKIP
아래에 해당하면 문장을 쓰지 말고 SKIP하세요. 억지로 쓴 설명은 설명이 없는 것보다 나쁩니다.
1. 두 상품을 함께 쓰는 요리가 바로 떠오르지 않을 때
   - 예: 고구마 ← 소고기 부채살, 생굴 ← 감자, 두부 ← 김밥김, 닭볶음탕용 닭 ← 콩나물
2. 흔한 채소끼리 장을 같이 본 것일 뿐, 둘을 함께 쓰는 요리가 바로 떠오르지 않을 때
   - 예: 시금치 ← 애호박, 브로콜리 ← 양배추, 오이 ← 청경채, 양배추 ← 단호박
   - "나물로 무쳐 비빔밥에"처럼 각자 따로 쓰는 쓰임을 이어 붙여야 설명이 되면 SKIP입니다.
   - 단, 전골·샤브샤브처럼 채소와 버섯을 한 냄비에 함께 넣는 쓰임이 분명하면 작성합니다.
3. 두 상품이 같은 종류라서 하나를 고르는 관계일 때
   - 예: 만두 ← 돈까스, 현미 ← 혼합곡, 고등어 ← 삼겹살
4. 추천 상품이 요리 재료로 보기 어려울 때

## 출력
JSON 한 개만 출력합니다. 다른 텍스트는 쓰지 마세요.
{"decision": "write", "text": "<설명 문장>"}
또는
{"decision": "skip", "skip_reason": "<짧은 이유>"}

## 예시
(작성 8건, SKIP 3건. 입력 JSON과 출력 JSON 쌍)
최종 프롬프트로 Claude Opus 5.5가 12,105건을 썼고 무료 혜택을 받고 있지만 적지않은 비용($120 정도)이 나왔다.
3. SFT - 소형 모델에게 가르치기
큰 LLM (Claude Opus 5.5) 으로 근거 묶음 12,105건에 대한 설명을 만들었다. 프롬프트는 생성하는 동안 바꾸지 않았고 SKIP한 결과도 버리지 않고 학습 데이터에 넣었다.
1) 소형 모델과 학습 데이터
전에 작성한 포스트에서 썼던 Gemma 3 4B(약 40억 파라미터)의 튜닝 버전을 골랐다. 고른 기준은 두 가지였다. 한국어 문장을 자연스럽게 쓸 수 있을 것 그리고 학습한 뒤에는 외부 API 없이 직접 운영할 수 있을 만큼 작을 것. 4비트로 양자화하면 모델 파일이 약 2.5GB라서 GPU 없는 서버에서도 돌릴 수 있을 것이라 생각했지만 내가 사용하는 서버는 그 정도 성능을 내기에도 힘이 들었다.
소형 모델의 입력은 한 문장짜리 지시문과, 숫자를 뺀 근거 묶음뿐이다.
지시문:
장보기 앱에서 추천 상품 아래에 붙는 설명을 씁니다. 근거 상품과 추천 상품을 함께 쓰는 쓰임을 1~2문장, 50자 이내의 해요체로 쓰고, 둘을 함께 쓰는 요리가 분명하지 않으면 skip합니다. JSON으로만 답합니다.
입력:
{"recommended_item": "사조대림 초특가 얇은 사각어묵 240G*2", "recommended_scate": "어묵",
 "reason_item": "풀무원 밀 떡볶이떡 550G",
 "basket": ["풀무원 밀 떡볶이떡 550G", "농협목우촌 주부9단 비엔나 250G*2", "..."]}
출력:
{"decision": "write", "text": "떡과 어묵으로 매콤한 떡볶이 어떠세요?"}
reason_share, pair_count, lift 같은 숫자는 입력에서 뺐다. 큰 LLM은 이 숫자를 SKIP 판단에 참고했지만 소형 모델은 큰 LLM이 내린 판단의 결과를 배우므로 숫자가 없어도 된다. SKIP일 때의 이유(skip_reason)도 빼고 {"decision": "skip"}만 남겼다.
데이터 구성
: 12,105건을 학습 10,913건, 검증 582건, 테스트 610건으로 나눴다.
SKIP도 그대로 학습
: 학습 데이터의 32%가 SKIP이고, 소형 모델은 "이 쌍에는 설명을 쓰지 않는다"는 판단까지 함께 배운다.
위에도 언급했지만 소형 모델이 배우는 학습 데이터가 늘 설명 문장만 있는게 아니라는 뜻이다. 떡볶이떡 -> 어묵 처럼 명확한 관계는 설명이 붙겠지만 애호박 -> 시금치 와 같은 관계는 skip 을 하도록 학습데이터에 그대로 넣고 해당 관계도 같이 배우는 것이다.
2) 학습 설정
예전 포스트에서 봤듯이 모델 전체를 다시 학습하는 대신 LoRA로 학습했다. 여기에 원래 가중치를 4비트로 불러오는 QLoRA를 써서 메모리를 더 줄였다. 학습할 파라미터는 약 3천만 개로 전체의 1% 미만이고 colab A100 장비로도 충분했다.
| 설정 | 값 |
|---|---|
| 소형 모델 | Gemma 3 4B 지시문 튜닝 (4비트 양자화, Unsloth) |
| 학습 방식 | QLoRA |
| LoRA rank / alpha | 16 / 16 |
| 적용 대상 | 언어 모델의 attention과 MLP 층 (이미지 처리 층은 제외) |
| 학습률 | 2e-4 |
| 에폭 | 1 |
| 배치 크기 | 16 (장치당 8 × 누적 2) |
| 최대 길이 | 1,024토큰 |
from unsloth.chat_templates import train_on_responses_only

trainer = train_on_responses_only(
    trainer,
    instruction_part="<start_of_turn>user\n",    # 여기서부터는 입력 (채점 안 함)
    response_part="<start_of_turn>model\n",      # 여기서부터는 답 (채점함)
)
위처럼 학습할 때는 답(출력) 부분만 채점했다. 학습 데이터 한 건은 지시문, 입력, 답이 이어진 글인데 기본 설정으로 학습하면 모델은 지시문과 장바구니 상품명까지 맞히는 연습을 한다. 하지만 입력은 서비스에서 우리가 넣어 주는 것이라 모델이 맞힐 필요가 없다.
Unsloth의 train_on_responses_only로 이 범위를 지정했다. Gemma의 대화 형식에서 사용자 차례는 <start_of_turn>user, 모델 차례는 <start_of_turn>model로 시작한다. 이 두 표시를 알려 주면, 사용자 차례(지시문과 입력)의 토큰은 손실 계산에서 빠지고 모델 차례(답 JSON)의 토큰만 손실에 들어간다.
from unsloth.chat_templates import train_on_responses_only

trainer = train_on_responses_only(
    trainer,
    instruction_part="<start_of_turn>user\n",    # 입력: 손실에서 제외
    response_part="<start_of_turn>model\n",      # 답: 손실에 포함
)
이렇게 하면 모델은 "이 입력이면 어떤 문장을 쓸지, 쓰지 않을지"를 배우는 데만 집중한다. 입력이 400자 안팎이고 답은 50자도 안 되는 이 데이터에서는 효과가 특히 크다. 전체를 채점하면 점수의 대부분이 정작 배울 필요 없는 입력에서 나오기 때문이다.
4. 평가와 데모
학습한 소형 모델이 정말 쓸 만한지 확인한다. 질문은 세 가지다. 형식과 규칙을 지키는가, 써야 할 때와 쓰지 말아야 할 때를 큰 LLM처럼 가리는가, 그리고 실제 서비스에 올릴 수 있는가.
1) 어떻게 평가했나
학습에 쓰지 않은 test 데이터 610건(402쌍)으로 평가했다. 쌍 단위로 나눴기 때문에 모델은 이 쌍들을 학습 중에 본 적이 없다. 큰 LLM의 답(작성 또는 SKIP)을 정답으로 두고, 소형 모델이 같은 입력에 낸 답과 비교했다. 소형 모델은 샘플링 없이 가장 확률이 높은 답을 고르게 해서(greedy), 같은 입력에는 항상 같은 답이 나오게 했다.
학습은 colab A100한 장에서 1에폭(683스텝)에 약 2시간 20분 걸렸다. 학습한 파라미터는 약 2,980만 개로 전체 43억 개의 0.69%다.
2) 결과
| 지표 | 결과 |
|---|---|
| 형식 정확도 (JSON으로 읽히는 비율) | 100% (610/610) |
| 판단 일치 (작성/SKIP이 큰 LLM과 같음) | 80.8% |
| SKIP 비율 | 소형 모델 33.6% / 큰 LLM 33.8% |
| SKIP 정밀도 / 재현율 | 71.7% / 71.4% |
| 규칙 위반 (50자 초과, 숫자, 느낌표, 품질 단정어) | 0건 (작성 405건 중) |
| 평균 길이 | 31.6자 (큰 LLM 33.6자) |
SKIP 재현율은 큰 LLM이 SKIP한 것 중 소형 모델도 SKIP한 비율이고, 정밀도는 소형 모델이 SKIP한 것 중 큰 LLM도 SKIP한 비율이다.
형식과 규칙은 완벽하게 배웠다. 6,000자짜리 규칙을 한 번도 프롬프트로 받지 않았는데도, 610건 모두 올바른 JSON을 냈고 작성한 문장 중 규칙을 어긴 것은 없었다. SKIP 비율도 큰 LLM과 거의 같았다.
둘 다 문장을 쓴 쌍을 나란히 놓으면, 상당수는 큰 LLM과 거의 같거나 똑같다.
| 쌍 (근거 - 추천) | 큰 LLM | 소형 모델 |
|---|---|---|
| 메추리알 - 꽈리고추 | 메추리알과 꽈리고추로 짭조름한 장조림 어떠세요? | 메추리알과 꽈리고추로 짭조름한 장조림 어떠세요? |
| 무 - 쪽파 | 무와 쪽파로 아삭한 깍두기 담가 보는 건 어떠세요? | 무와 쪽파로 아삭한 깍두기 어떠세요? |
| 새우살 - 깐마늘 | 새우살에 마늘을 더하면 감바스나 버터구이로 즐기기 좋아요. | 새우살 요리라면 깐마늘도 챙겨 보세요. 볶음이나 찌개에 함께 넣기 좋아요. |
다만 형식은 맞는데 뜻이 어색한 문장도 섞였다. 무와 찜갈비에 "시원한 찜", 맛술과 대파에 "맛술에는 대파가 잘 어울려요"처럼, 함께 쓰는 쓰임을 정확히 짚지 못한 경우다. 이런 경우는 보통 자동 지표로는 잡히지 않아 사람이 읽어야 보인다.
3) 빠뜨리는 것보다 지어내는 게 더 나쁘다
큰 LLM은 SKIP했는데 소형 모델이 쓴 경우는 문제가 컸다. 배추 - 떡국떡에 "떡국떡과 배추로 따끈한 떡국 어떠세요?", 달걀 - 삼치에 "볶음밥 위에 프라이를 올려 보세요"처럼 없는 요리를 지어냈다. 억지 설명이 설명이 없는 것보다 나쁘다.
그래서 SKIP 판단에 문턱값을 두었다. 출력은 항상 {"decision": "로 시작하므로, 바로 다음 토큰에서 write와 skip의 확률을 비교하면 모델이 SKIP을 얼마나 확신하는지 알 수 있다. 모델이 문장을 쓰기로 했더라도 SKIP 확률이 문턱값 이상이면 SKIP으로 처리한다. 검증 데이터 582건으로 문턱값을 바꿔 보면 이렇다.
| SKIP 확률 문턱값 | SKIP 비율 | SKIP 정밀도 | SKIP 재현율 | 잘못 작성 (큰 LLM은 SKIP) |
|---|---|---|---|---|
| 0.5 (모델 판단 그대로) | 29.2% | 77.1% | 73.2% | 48건 |
| 0.4 | 33.7% | 73.5% | 80.4% | 35건 |
| 0.3 (채택) | 39.3% | 69.4% | 88.8% | 20건 |
| 0.2 | 45.7% | 62.8% | 93.3% | 12건 |
| 0.1 | 73.7% | 41.5% | 99.4% | 1건 |
0.3을 골랐다. 잘못 쓴 문장이 48건에서 20건으로 절반 넘게 줄고, SKIP 비율은 큰 LLM(약 31~34%)보다 조금 높은 수준에 머문다. 이보다 낮추면 쓸 만한 설명까지 너무 많이 버린다. 다시 학습하지 않고 추론할 때 숫자 하나만 바꾸는 방법이라 비용이 들지 않았다.
4) 서버에 적용하기
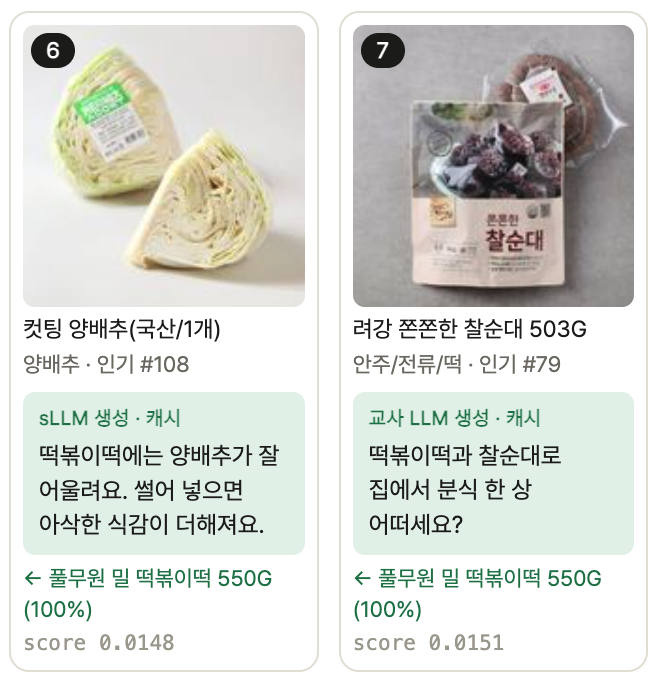
데모에서는 소형 모델을 요청마다 부르지 않고, 설명이 나올 수 있는 쌍 전체에 미리 문장을 만들어 두었다. 내가 사용하는 서버 성능이 문제였지만 실서비스도 redis 같은 캐시 레이어를 하나 두는 게 좋겠다 싶다.
서버에는 GPU도 LLM도 없다. 미리 만들어둔 문장 표를 불러오는 데 0.4초, 메모리는 130MB 안팎이고, 추천과 설명을 함께 계산해도 한 번에 2~4ms다. 데모의 주제별 장바구니로 만든 추천 540건 중 241건(44.6%)에 설명이 붙었다.
결과는 꽤 만족스럽다. 다만 돌아보면, 지금처럼 (추천 상품, 근거 상품) 쌍만으로 설명이 정해진다면 큰 LLM으로 쌍마다 미리 문장을 만들어 두는 편이 더 간단했을지도 모른다. 쌍의 수는 유한하고, 12,000건을 만드는 데 든 비용도 적지 않았다.
그래도 SFT한 작은 모델을 택한 이유는, 이 설명이 앞으로 갈 방향 때문이다. 장바구니 맥락에 따라 문장이 달라지고, 고객의 구매 이력이 들어가고, 신상품이 매주 추가되기 시작하면 미리 만들어 둔 캐시는 금방 한계에 부딪힌다.
이때 필요한 건 처음 보는 조합에도 바로, 싸게, 문장을 만들어 낼 수 있는 모델이다. 실제 서비스라면 자주 나오는 쌍은 캐시로, 처음 보는 조합과 개인화된 문장은 작은 모델로 처리하는 혼합 구성이 가장 현실적일 것이다.

클릭하여 데모페이지로 이동