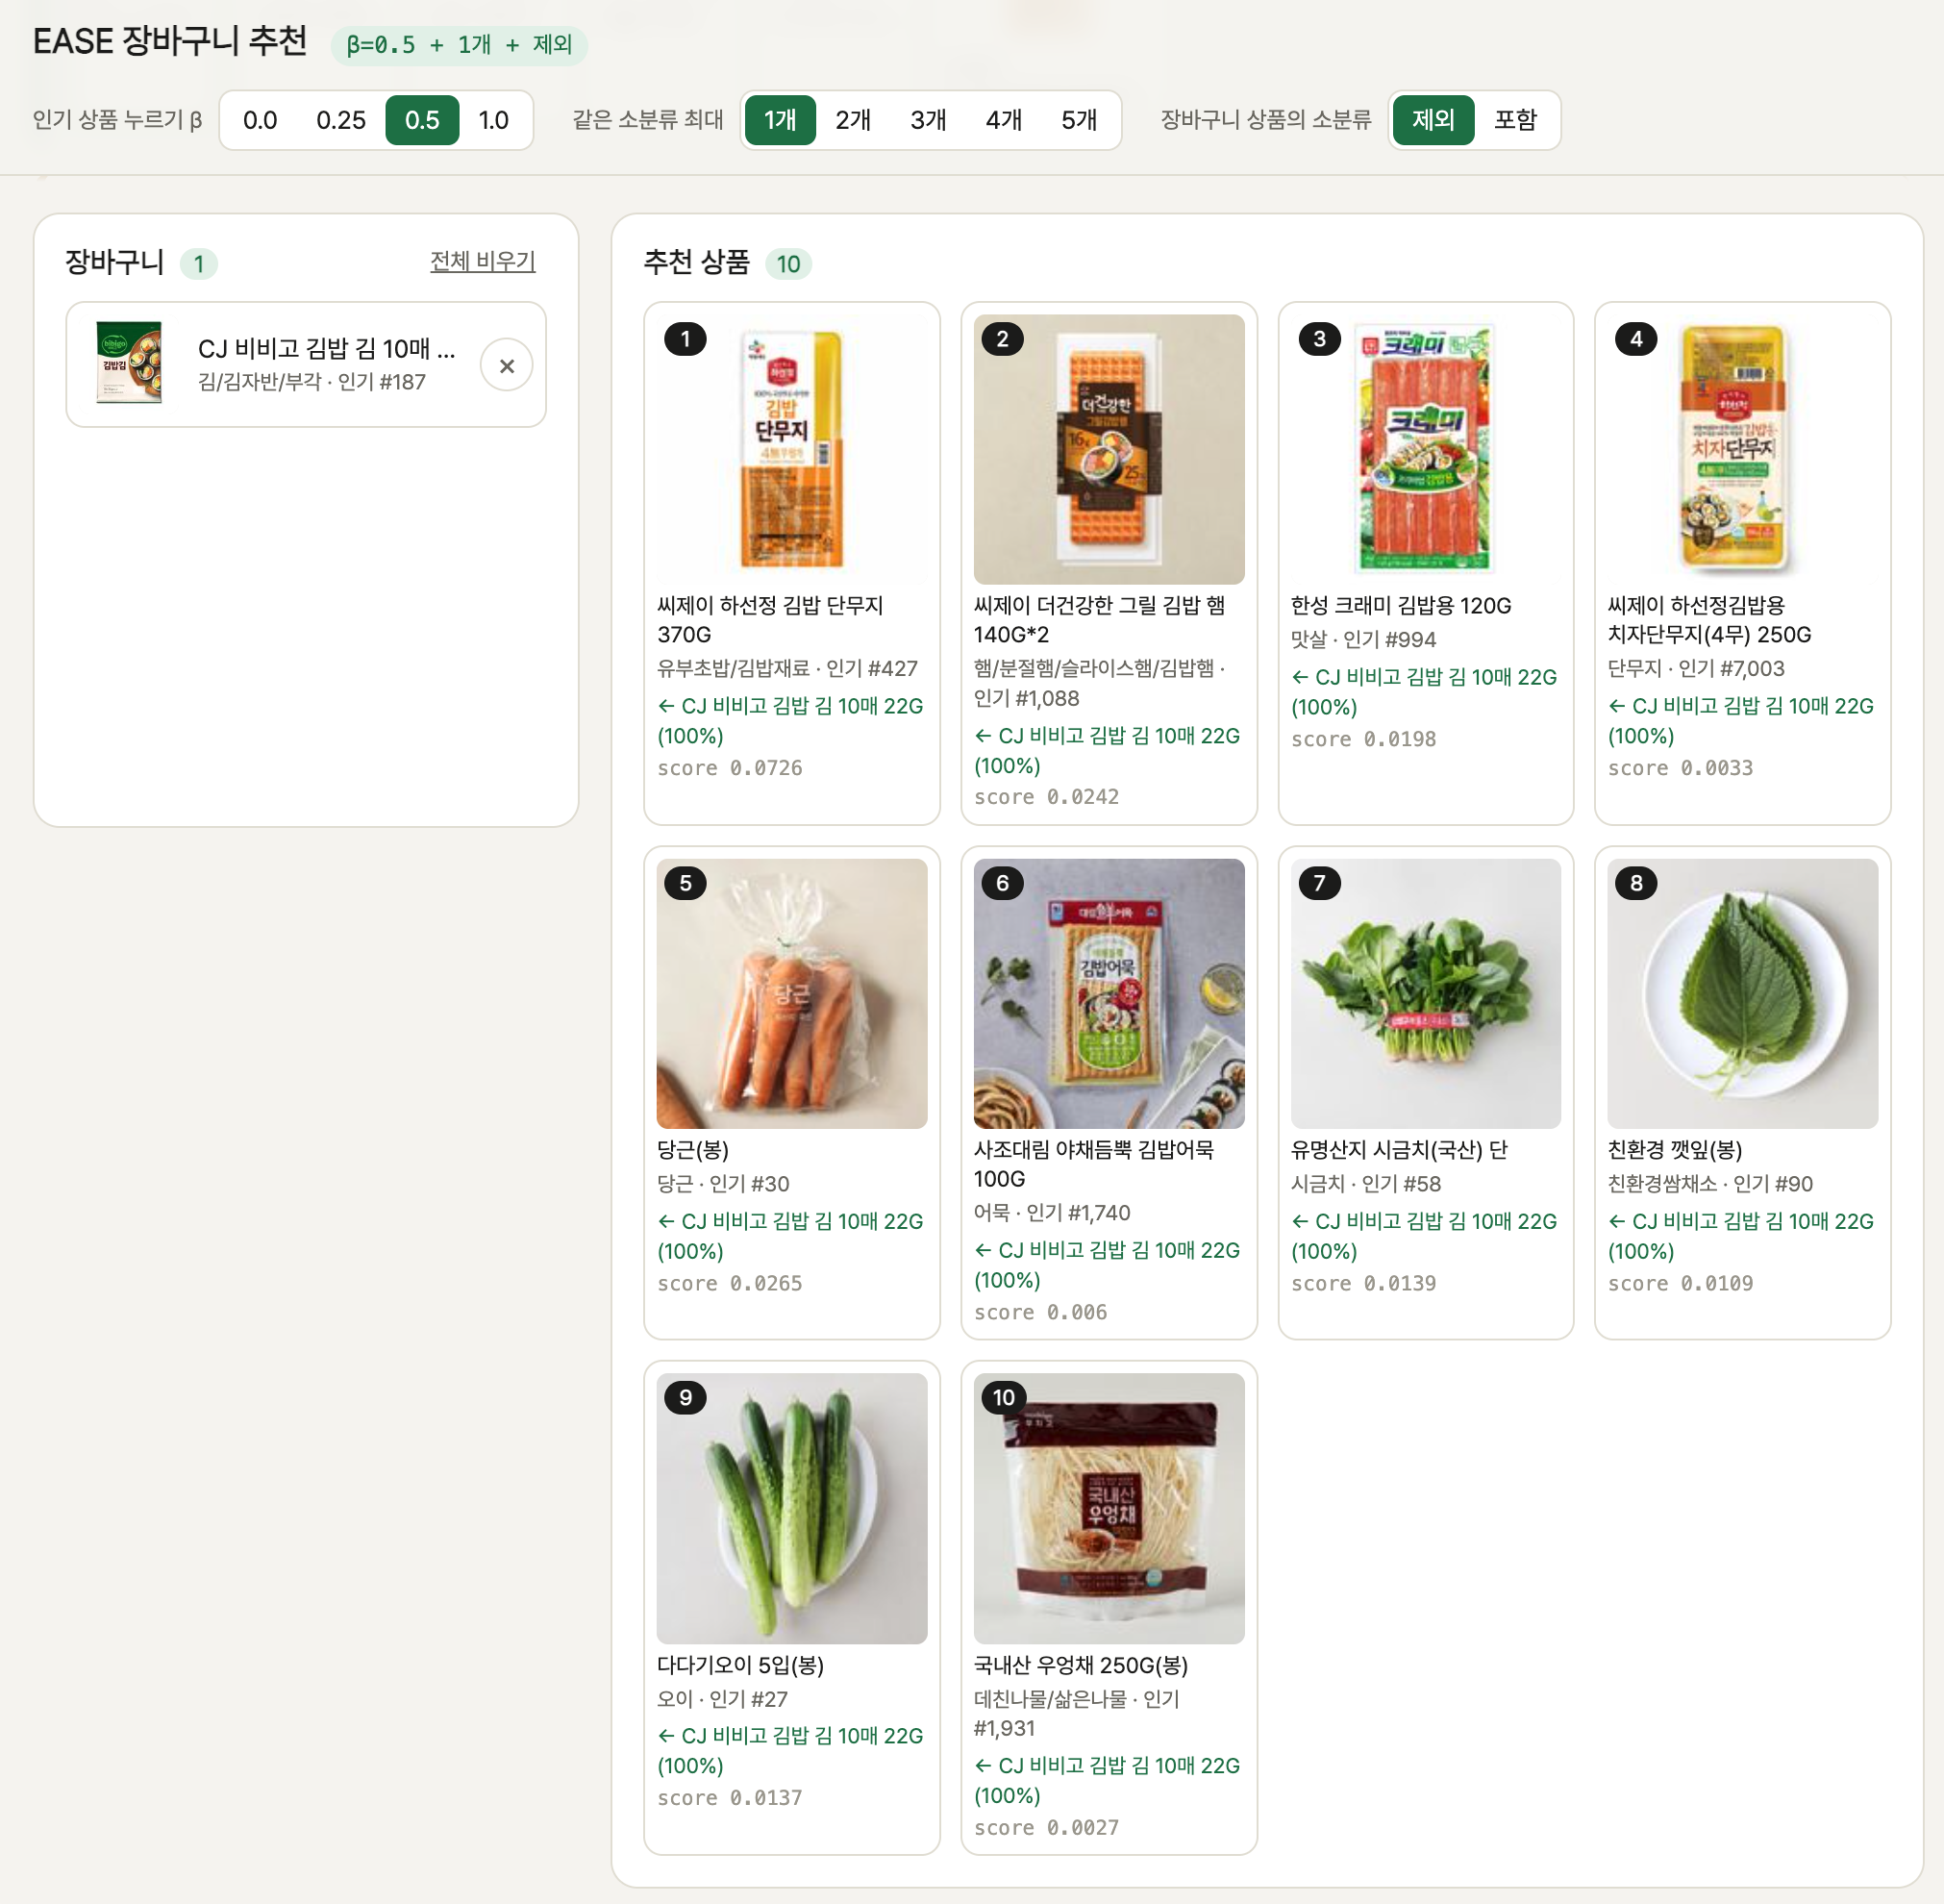
그로서리 추천 시스템에서 소형 LLM SFT 로 추천사유 만들기 -1-


왜 추천사유인가
장을 볼때 보통 우리는 어떤 방식으로 상품을 고르는지 떠올려봤다. 보통은 "오늘 저녁은 된장찌개" 처럼 메뉴를 먼저 떠올리고, 거기에 필요한 재료를 담고 그리고 떨어질때가 된 우유나 계란을 같이 챙길 것이다.
그런데 대부분의 추천 영역은 이런 맥락이 없이 상품만 나열하곤 한다. 고객입장에서는 왜 이 상품이 나왔는지 알 수 없으니 추천이 우연히 걸린 광고처럼 느껴지기 쉽다.
여기에 "된장찌개 재료를 담으셨네요, 대파는 어떠세요?" 같은 한 줄이 붙으면 어떨까. 추천이 고객의 장바구니를 이해하고 있다는 신호가 되고 고객은 그 상품이 지금 필요한지를 바로 판단 할 수 있다. 그로서리는 끼니와 재구매라는 뚜렷한 구매 목적이 있는 도메인이라 추천사유가 특히 잘 어울린다.
문제는 이 문장을 누가 어떻게 만드느냐이다. LLM 에게 장바구니를 보여주고 이유를 써달라고 하면 문장은 그럴듯 하지만 , 실제 추천 근거와 상관없는 이유를 지어낼 수 있으므로 하지 말아야할 것들을 적은 장황하고 긴 프롬프트를 적어야 할지 모르겠다. 아마도 LLM 비용도 적지 않을 것이다.
그래서 이번 포스트에서는 추천사유를 만드는 소형 LLM 을 파인튜닝하기 전에 필요한 추천엔진을 간단하게 만들어 보기로 하고, 다음 포스트에서 SFT 로 학습한 소형 LLM 을 학습하고 테스트 하는 과정을 다루고자 한다.
01.추천 모델 준비
추천사유를 만드려면 먼저 추천이 있어야 하고 간단한 추천 모델을 만드는 과정도 정리해본다.
1) 구매이력을 장바구니로
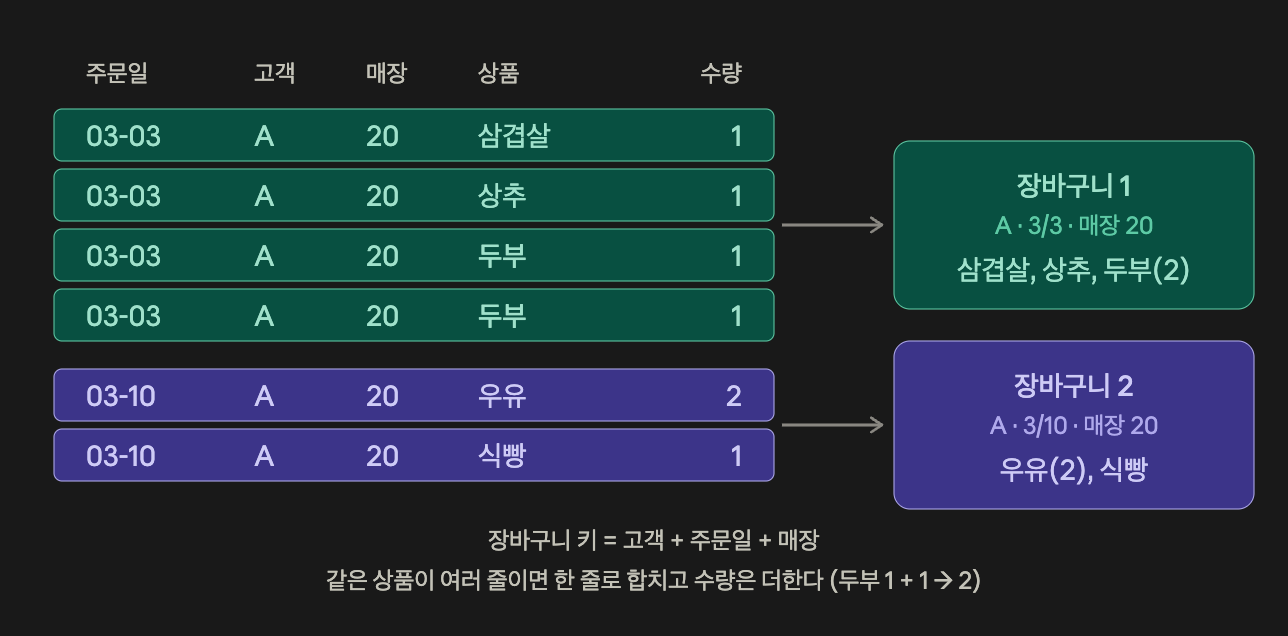
먼저 학습 데이터는 2025년 기준 한 해 동안의 그로서리 기준의 마트 구매이력(약 2억행)을 사용했고 같은 고객이 같은 날 같은 매장에서 산 상품을 하나의 장바구니로 정의했다. 해당 데이터를 학습하기 위해 정제를 했는데 기준은 다음과 같다.
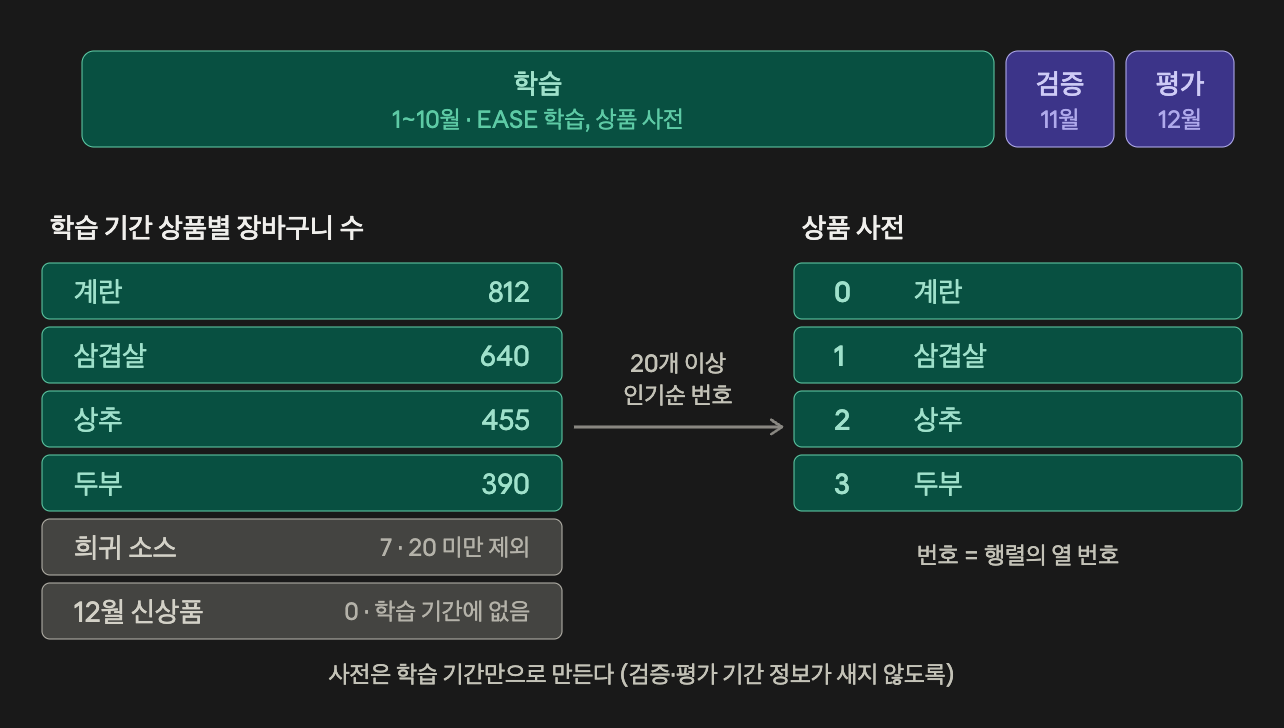
- 학습 기간 동안 판매횟수가 20회 미만인 상품은 다른 상품과의 관계를 배울 데이터가 없으므로 제외 (66,076개 중 39,465개 유지)
- 상품이 100개 이상 넘게 담긴 장바구니는 업소용 대량 구매로 보고 제외
결과적으로 이렇게 정리한 장바구니에는 평균 9.4개 정도의 상품이 담겨 있었다.
2) 평가 설계와 방식
1년 기준의 데이터를 가지고 추천 모델을 만들기에는 조금 애매하지만 다음과 같은 기준으로 데이터를 활용하기로 했다.
| 구분 | 기간 | 장바구니 |
|---|---|---|
| 학습 | 1~10월 | 1,598만 |
| 검증 | 11월 | 147만 |
| 평가 | 12월 | 158만 |
평가 방식은 장바구니 일부 가리기를 하기로 했고 12월 장바구니에서 상품의 20%를 무작위로 가리고 나머지 상품만 보고 가려진 상품을 맞히게 했다. 지표로는 가려진 상품이 추천 상위 20개 안에 들어간 비율인 Recall@20을 썼다.
여기서 신경써서 처리해야 하는 것이 "고객이 이전에 산 적이 있는 상품"인지에 따라 두가지 유형으로 나눠서 따로 평가해야했다.
두 가지 유형으로 나눈 이유는 맞히는 방식이 다르기 때문인데, 재구매 상품은 고객의 과거 이력을 기준으로 다소 쉽게 맞힐 수 있지만 처음사는 상품은 "두부, 애호박, 된장을 담았으니 대파가 필요하겠다" 처럼 지금 장바구니의 맥락을 읽어야 맞힐 수 있다.
게다가 최종적으로 만들고자 하는 추천사유에서 처음 사는 상품에는 "된장찌개 재료를 담으셨네요", 재구매 상품에는 "평소 자주 사시는 우유예요" 같은 설명이 어울릴 것이고 나중에 SFT 를 만들 학습 데이터도 이처럼 나눠야 할 것이다.
3) 추천 모델 선택하기
모델을 고르기전에 최종 목표(상황에 따른 추천사유 출력)을 기준으로 갖춰야 할 조건을 정리해봤다.
- 장바구니의 맥락을 읽고 추천해야한다.
- 왜 이 상품이 추천됐는지 확실한 근거가 있어야 한다.
- 빠르게 실험할 수 있어야 한다.
| 모델후보 | 장바구니 맥락 | 근거 분해 | 학습 비용 | 비고 |
|---|---|---|---|---|
| 동시구매/연관규칙 | 상품 쌍 단위 | 쉬움 | 낮음 | 다른 상품의 영향을 고려하지 못함 |
| 행렬 분해(ALS) | 약함 | 어려움 | 중간 | 고객 단위 취향 모델 |
| Item2Vec | 가능 | 어려움 | 중간 | "비슷한 상품"이라는 이유밖에 못 줌 |
| Two-Tower | 가능 | 어려움 | 높음 | 상품 피처가 풍부해야 장점이 생김 |
| 시퀀스 모델 | 가능 | 어려움 | 높음 | 장바구니 안 상품 순서가 의미 없음 |
| EASE | 가능 | 쉬움 | 낮음 | 상품 수에 따라 메모리 부담 |
동시구매 통계는 상품 쌍 하나씩 본다는 한계가 있고 계란이나 우유처럼 어디에나 담기는 상품은 무엇과도 잘 팔리니 늘 상위에 오를 것이다. 추천모델 보다는 보조지표정도로 사용하는게 좋을 긋 하다.
ALS, Item2Vec, TwoTower 는 상품과 고객을 벡터로 표현하는 방식이다. 성능은 나쁘지 않은데 점수가 벡터의 내적으로 나오기 때문에 "어떤 상품때문에 추천됐는지" 를 분리하기 어렵다.
시퀀스모델은 순서가 중요한데 장바구니 안에 상품 순서는 의미가 없다.
4) EASE (Embarrassingly Shallow AutoEncoder) 에 대한 이야기
Harald Steck, “Embarrassingly Shallow Autoencoders for Sparse Data”, WWW 2019. arXiv
최종적으로 선택한 추천모델은 EASE 인데, 이름 그대로 "민망할 만큼 얕은" 오토인코더이다. 은닉층이 없이 상품x상품 가중치 행렬 하나로 장바구니를 복원하는데, 이 단순한 구조로도 딥러닝 추천 모델과 대등한 성능을 낸다는 점에서 붙은 이름이다.
EASE 는 다음 조건을 모두 만족한다.
- 장바구니만 넣으면 바로 점수가 나온다.
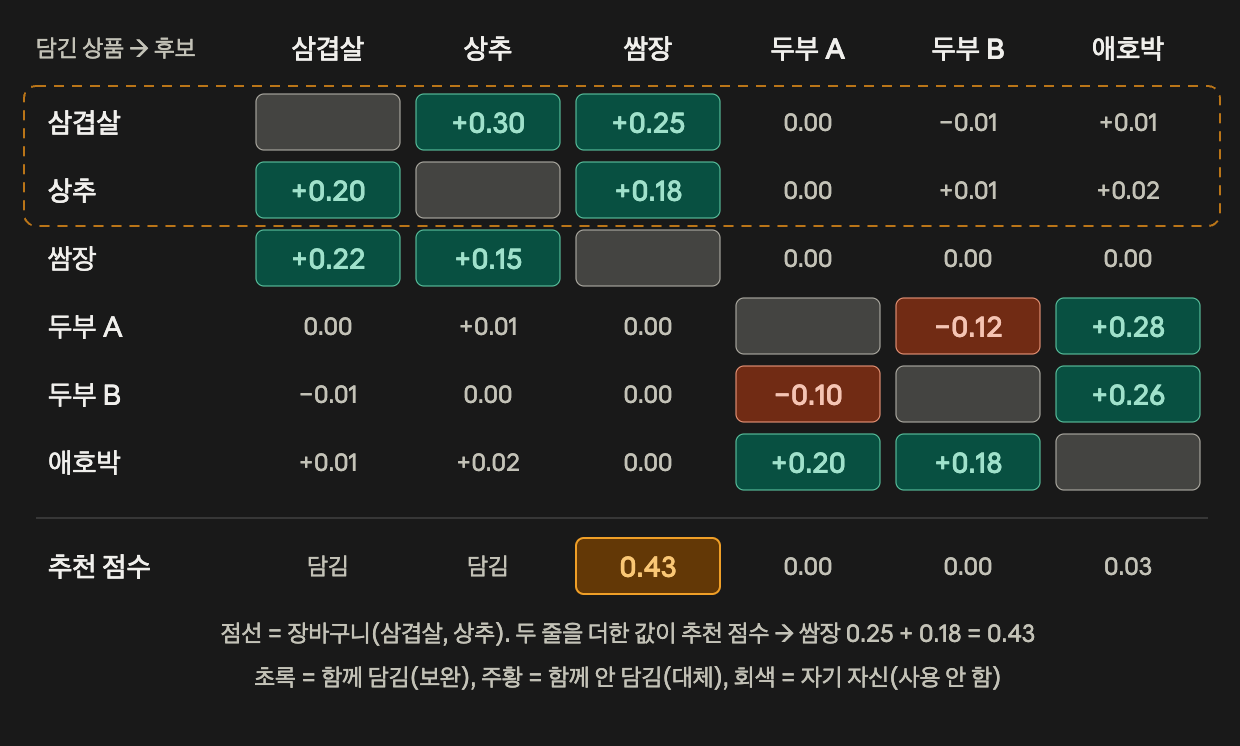
EASE 가 학습하고 난 결과물은 "상품 i 를 담으면 상품 j 의 점수가 얼마나 올라가는가" 를 적어둔 큰 행렬 하나다. - 점수가 단순 합이라 근거가 그대로 보인다.
두부 → 대파 +0.31
애호박 → 대파 +0.24
된장 → 대파 +0.18
──────────────────
대파 점수 0.73
위처럼 장바구니에 두부, 애호박, 된장이 담겨있고 대파의 점수를 계산 한다고 하면 단순히 더하기만 하면 됨으로, 대파가 추천된 이유가 두부 때문이 가장많이 그다음은 애호박 때문이라는 걸 바로 알 수 있다. 반면 벡터를 쓰는 모델은 숫자를 섞고 곱해서 나오기 때문에 어느 상품이 얼마나 기여했는지 깔끔하게 떼어내기가 어렵다.
- 역행렬 한 번이면 학습이 끝난다
2 * x = 10 에서 x 를 구한다고 가정하면, 딥러닝은 x 를 여러번 바꿔가며 오차를 줄이는 방향으로 가중치를 조금씩 고쳐나가는 과정이라면 EASE 는 양변을 2로 나눠 x = 10 ÷ 2 = 5 처럼 구하는 방식이다.
다만 숫자 하나가 아니라 2만x2만 크기의 행렬을 다루고 "2로 나누기" 에 해당하는 계산이 역행렬이다. 그래서 반복 없이 역행렬 한 번으로 정답 가중치가 나오가 상품 2만개 기준으로 3분여면 학습이 끝난다.
5) EASE 와 현실적인 제약
EASE는 단순하고 강력하지만, 실제 데이터에 적용해 보면 몇 가지 제약이 드러난다.
- 상품 수가 늘면 비용이 급격하게 커진다.
EASE의 점수표는 상품×상품 크기이며, 상품이 N개면 표의 칸은 N²개이고, 이 표를 만드는 역행렬 계산은 대략 N³에 비례해 무거워진다. 상품 수가 2배가 되면 메모리는 4배, 계산 시간은 8배 가까이 늘어나는 셈이다.
정제 후 남은 상품은 약 4만 개였지만, 메모리가 16GB인 노트북에서 학습하려면 더 줄여야 했다. 그래서 학습 기간 판매량 상위 2만 개만 사용했다. 상품 수로는 절반이지만 구매 라인 기준으로는 약 99%를 차지한다. - 고객 콜드스타트 문제는 없지만 상품 콜드스타트 문제는 존재한다.
상품 쪽 문제는 몇 가지로 완화할 수 있다. 학습이 몇 분이면 끝나니 주 단위로 다시 학습해 신상품을 빨리 반영할 수 있고, 신상품도 소분류는 있으니 뒤에서 소개할 소분류 단위 EASE로 대신 다룰 수 있다. - 고객이 "또 산다"는 사실을 모른다.
EASE는 지금 장바구니만 보기 때문에 고객이 무엇을 자주 사는지는 알지 못한다. 그래서 재구매형 설명의 근거는 EASE가 아니라 고객의 과거 구매 이력에서 따로 가져온다. - 어디에나 담기는 상품은 여전히 위로 올라온다
EASE는 다른 상품의 영향을 함께 고려하기 때문에 단순 동시구매 횟수보다는 흔한 상품의 영향이 작다. 하지만 완전히 사라지지는 않아서, 계란이나 우유, 생수가 여러 장바구니의 추천 상위에 꾸준히 올라온다.
실제로 함께 많이 사는 상품이니 추천 자체가 틀린 것은 아니지만, "삼겹살을 담으셔서 계란을 추천해요" 같은 설명은 어색하다.
02.추천 모델 만들기
학습전 전처리를 위해 데이터를 만드는 과정을 정리해본다.
1) 원본 구매 라인을 장바구니로 묶기
2) 기간 나누기와 상품사전 만들기
3) 장바구니 - 상품, 상호작용 행렬(X) 만들기
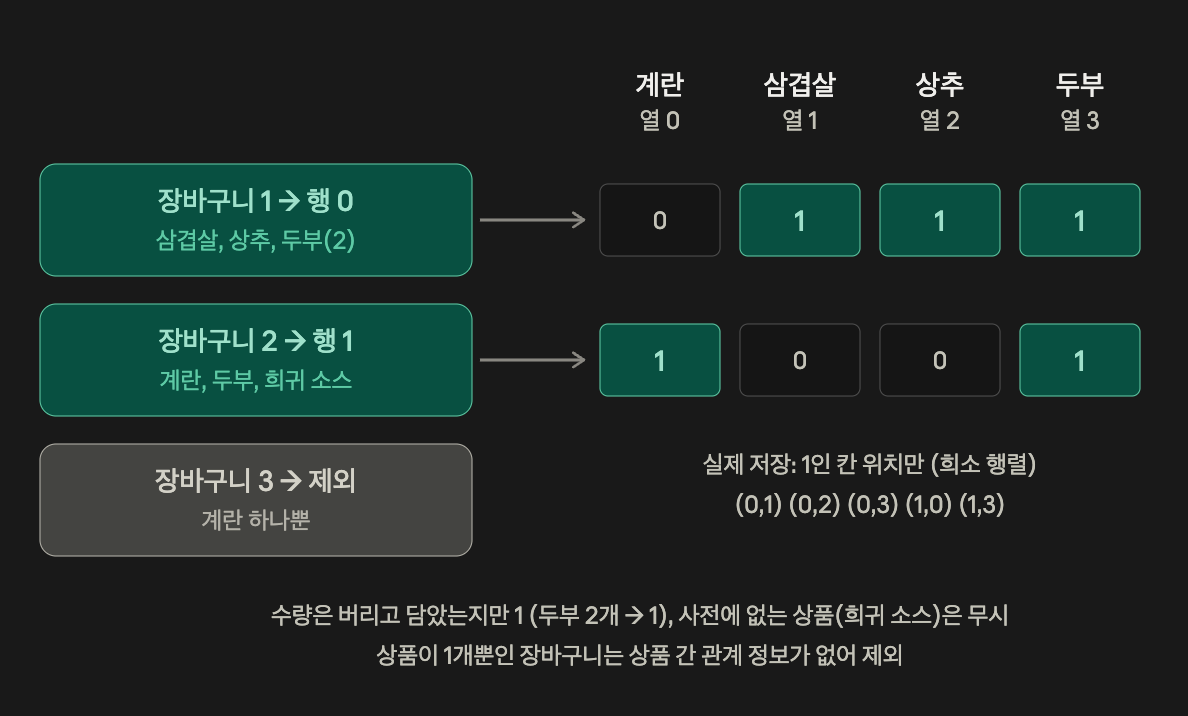
4) EASE 학습 - 함께 담긴 횟수 세기
G는 X를 보고 상품을 둘씩 짝지어, 두 상품이 함께 담긴 장바구니 수를 센 표다. 대각선에는 각 상품이 담긴 장바구니 수가 들어간다.
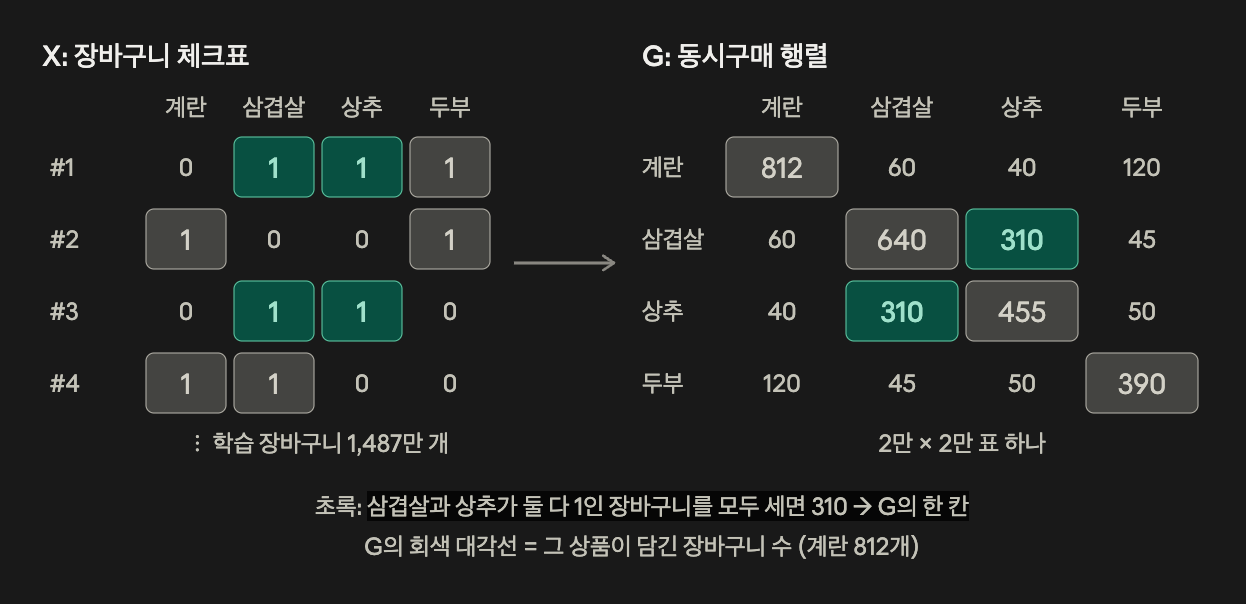
G는 "두 상품이 몇 번 함께 담겼나"를 센 횟수 표다. 하지만 추천에 필요한 건 횟수가 아니라 다른 상품들을 모두 감안했을 때, 상품 i가 담기면 상품 j의 점수가 얼마나 오르나 다. 점수표 B를 아래 3단계의 계산으로 만든다.
5) EASE 학습 - G 행렬 대각선에 λ 더하기
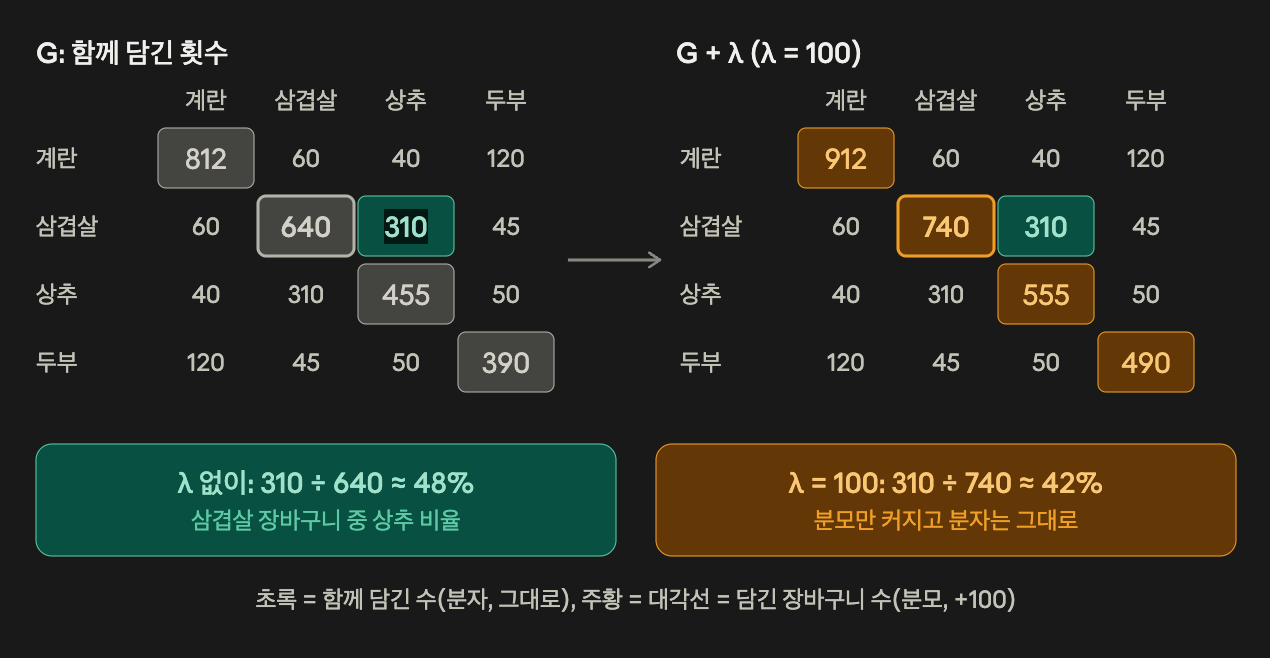
대각선에 λ 더하기를 하는 이유는 드문 조합을 과신하지 않게 하는 브레이크 역할을 하기 위해서다. 예시에서 λ는 모든 상품의 분모에 똑같이 100을 더하는 것인데, 분모가 작은 상품(데이터가 적은 상품)일수록 그 100이 상대적으로 커서 관계가 크게 줄고, 분모가 큰 상품은 거의 영향을 받지 않는다.
6) EASE 학습 - B 행렬구하기
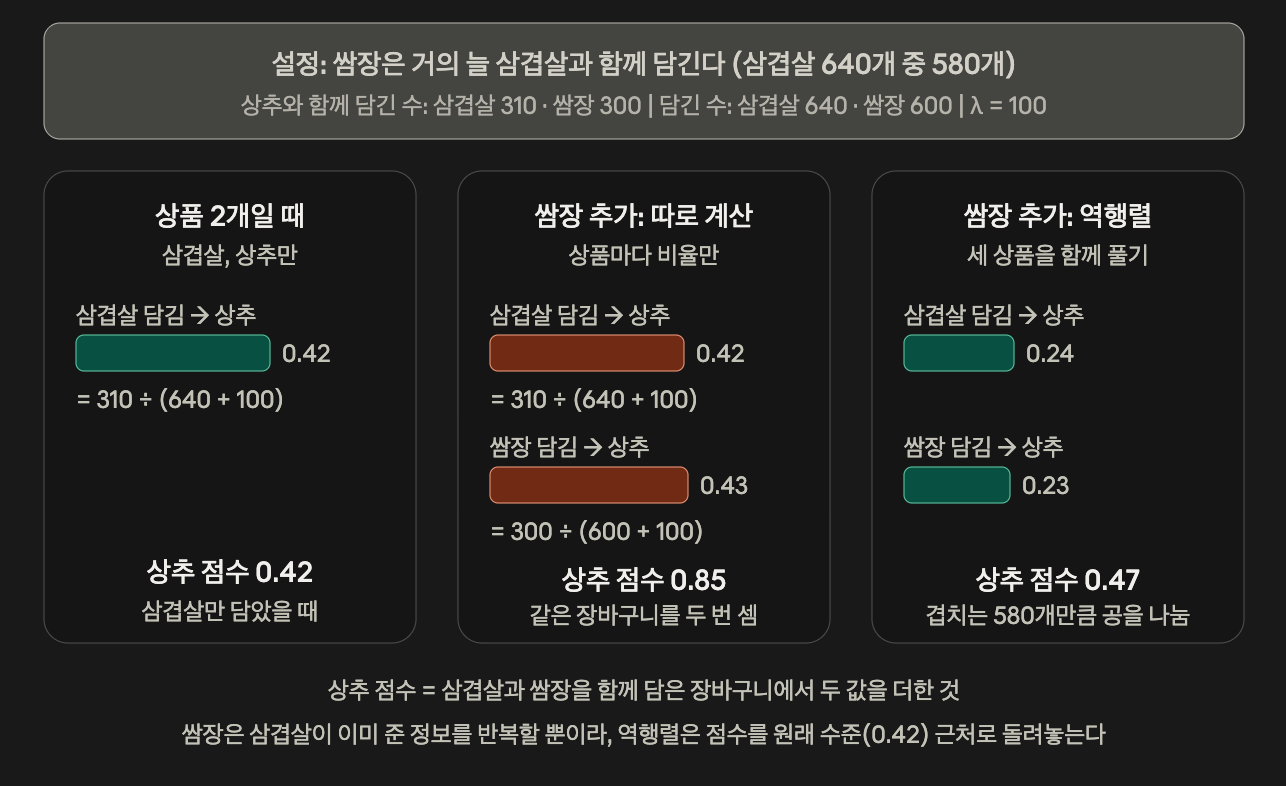
첫번째 그림은, 장바구니에 삼겹살을 담았을때 상추가 가지는 점수가 0.42 라는 것이다.
두번째 그림은, 삼겹살과 쌈장이 담겼을때 상추가 가지는 점수를 의미 하는데, 여기서 나타내는 상추의 점수는 0.85 는 "역행렬 없이 상품마다 비율로만 따지면 무엇이 잘못되는가"를 보여주는 그림이다.
삼겹살과 쌈장은 580개의 장바구니에서 함께 담겼는데, "삼겹살과 함께 상추가 담긴 310개"와 "쌈장과 함께 상추가 담긴 300개"는 사실상 같은 장바구니들이다.
결국 삼겹살과 쌈장을 둘 다 담았다면 상추 점수는 두 값을 더해 0.85가 되면서 더 과장이 되는 경우가 발생된다.
세번째 그림은, 역행렬로 세 상품을 함께 풀면 삼겹살과 쌈장이 얼마나 겹치는지(580)를 보고 공을 나눠 0.24와 0.23이 되고, 합이 0.47로 원래 수준 근처에 머무르게 된다는 것을 보여준다.
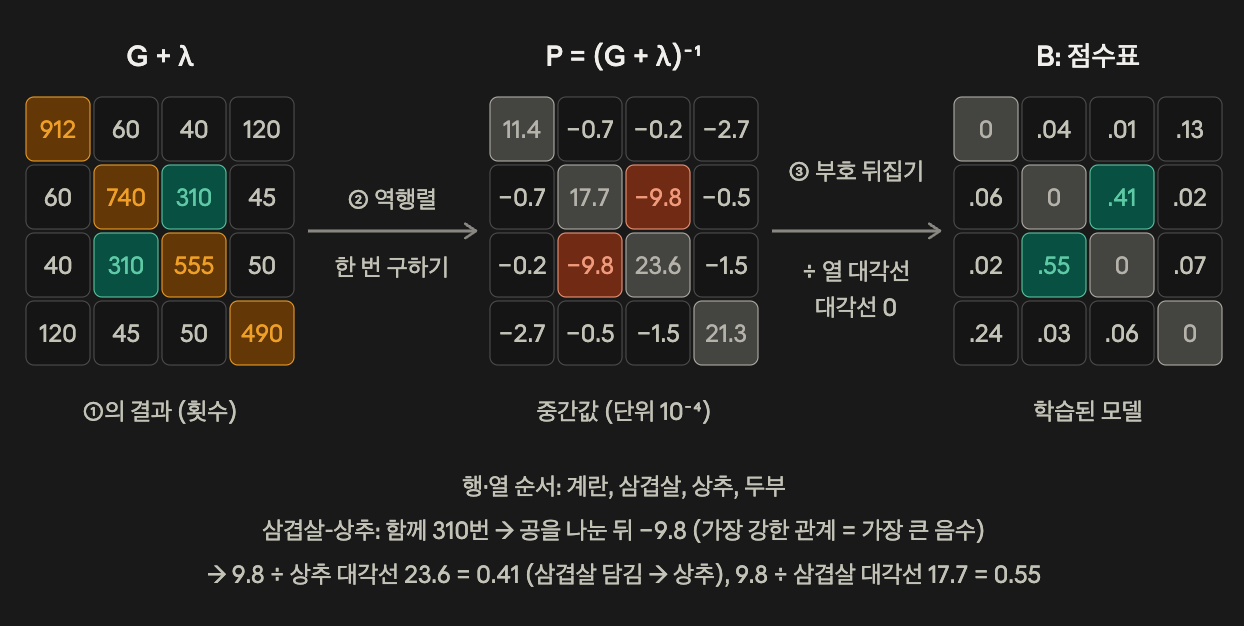
위 그림은 지금까지의 과정을 한 번에 정리한 것이다.
a. 함께 담긴 횟수 표(G)의 대각선에 λ를 더해 브레이크를 건다.
b. 역행렬을 구해 서로 겹치는 상품끼리 공을 나눈다. 결과 P에서는 관계가 강할수록 큰 음수가 나온다.
c. 양수는 음수로 음수는 양수로 부호를 뒤집고 나서, 역행렬의 숫자를 "비율"로 되돌리기 위해 각 열의 대각선 값으로 나눠 점수로 바꾸고, 자기 자신 칸은 0으로 비운다.
이렇게 만든 점수표 B가 학습된 EASE 모델이다.
03.추천 모델 평가하기
1) EASE 는 장바구니를 읽는가
먼저 추천을 제대로 하는지 확인해봤다. EASE가 정말 장바구니 맥락을 읽고 추천하는지, 아니면 잘 팔리는 상품을 내미는 것과 다를 바 없는지다.
위에서 설명한 대로 12월 장바구니에서 상품의 20%를 가리고, 나머지만 보고 가린 상품을 맞히게 했다.
a.평가 문제
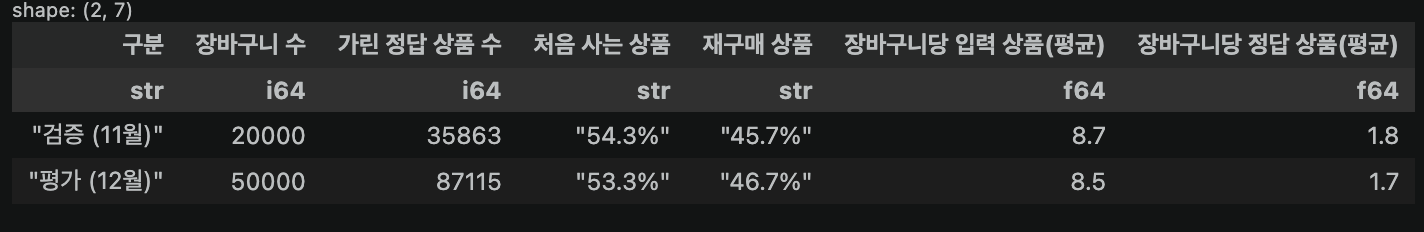
평가에는 12월 장바구니 5만 개를 썼다. 장바구니마다 평균 8.5개의 상품을 모델에게 보여주고, 나머지 1.7개를 가렸다.
모델이 추천한 상위 20개 안에 가린 상품이 들어 있으면 맞힌 것으로 본다. 가린 정답은 모두 8.7만 개이고, 그중 53%는 고객이 그 장바구니 이전에 한 번도 산 적 없는 상품이다. 과거 구매 이력만으로는 절반 이상을 맞힐 수 없는, 장바구니의 맥락을 읽어야 풀 수 있는 문제다.
b.평가 결과
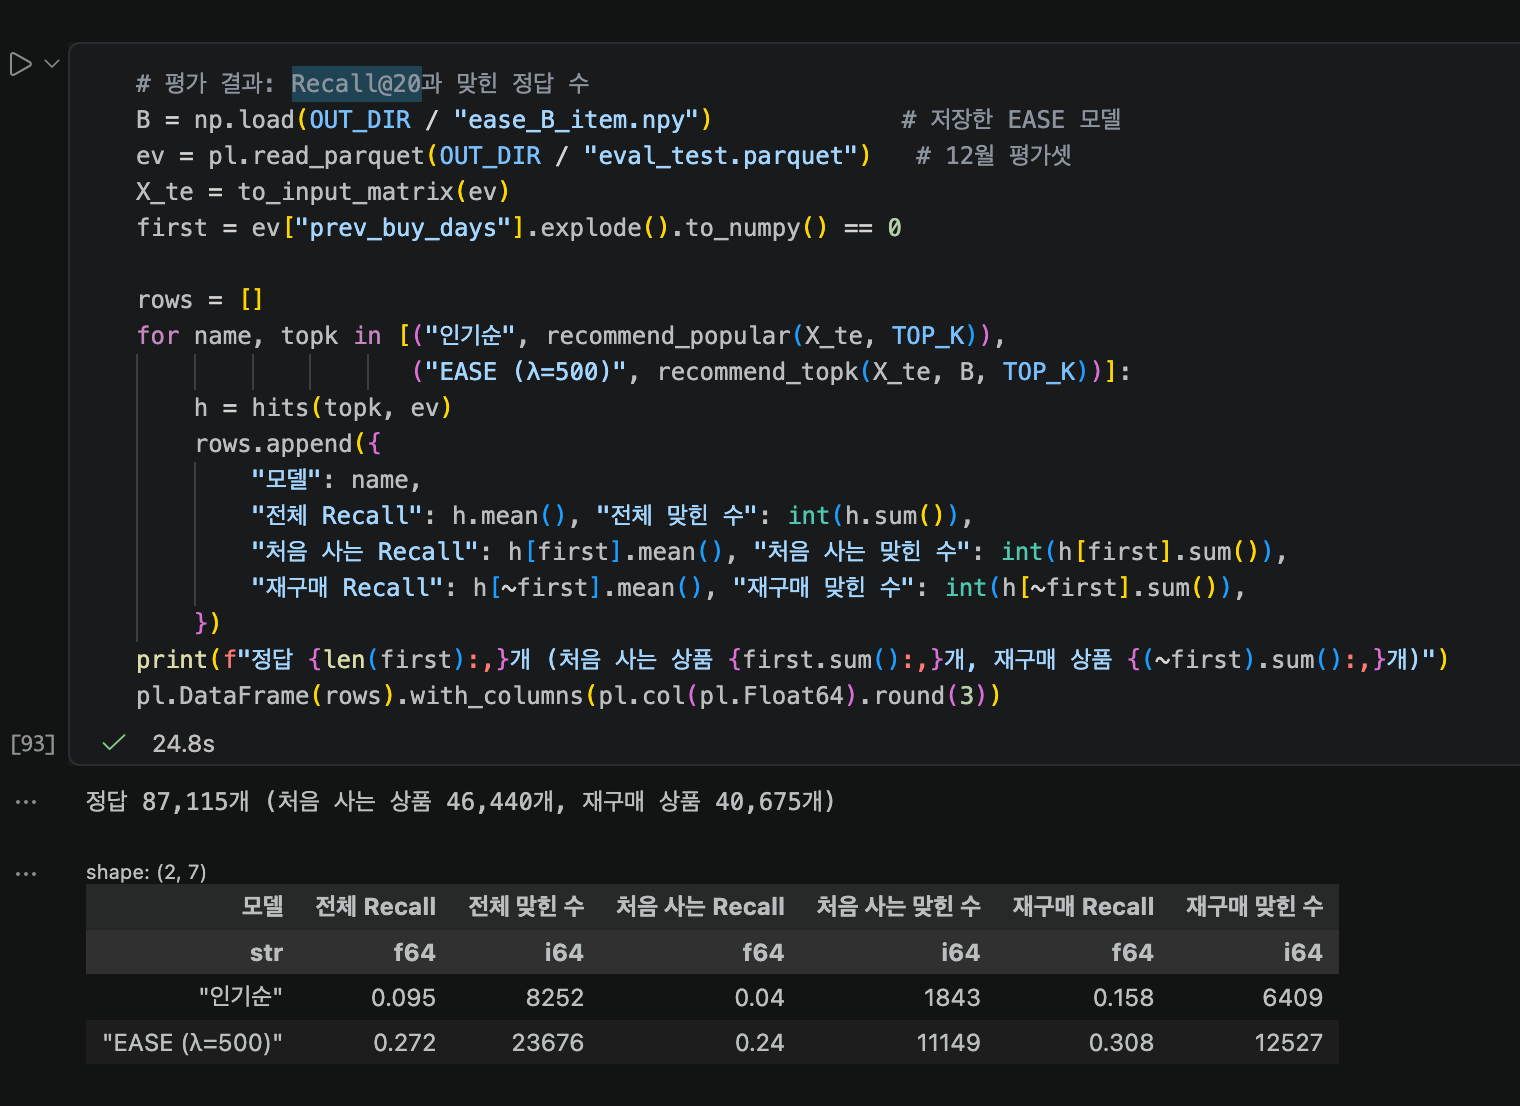
가린 정답 87,115개 중 인기순 추천은 8,252개(Recall@20 : 0.095), EASE는 23,676개(0.272)를 맞혔다.
차이는 고객이 처음 사는 상품에서 두드러진다. 처음 사는 정답 46,440개 중 인기순은 1,843개(0.040)에 그쳤지만, EASE는 11,149개(0.240)로 6배를 맞혔다.
무엇을 맞혔는지도 다르다.
인기순이 맞힌 상품의 78%는 재구매 상품으로, 우유나 달걀처럼 원래 자주 사던 상품을 늘 보여준 덕분이다.
반면 EASE가 인기순보다 더 맞힌 15,424개 중 약 60%는 처음 사는 상품이었다. EASE의 성능은 대부분 장바구니를 보고 고객에게 새로 필요한 상품을 찾아낸 데서 나온다.
2) 숫자 뒤에 숨은 "생필품 쏠림 문제"
Recall로 보면 EASE는 충분히 잘 작동한다. 그런데 실제 장바구니 하나를 넣고 추천 결과를 눈으로 보면 이야기가 달라진다.
삼겹살과 양상추를 담은 장바구니로 추천을 받아봤다. 1위는 같은 브랜드의 목심이고, 등갈비, 항정살, 적상추도 올라온다. 구이 장보기라는 맥락을 잘 읽은 결과다. 하지만 그 사이사이에 달걀 두 종류, 우유, 애호박, 방울토마토가 섞여 있다. 이 상품들의 전체 인기 순위는 1위, 2위, 3위, 6위다. 추천 10개 중 9개가 전체 1.5만 개 상품 중 인기 상위 100위 안에 드는 상품이었다.
a. 왜 이런 일이 생기나
EASE의 추천 점수는 장바구니에 담긴 상품들의 가중치를 더한 값이다. 달걀이나 우유는 삼겹살과 특별히 관계가 있어서가 아니라, 거의 모든 장바구니에 조금씩 함께 담기기 때문에 어떤 상품과도 작은 양수 가중치를 갖는다. 장바구니에 상품이 여러 개 담기면 이 작은 값들이 쌓여서, 정작 맥락에 맞는 상품을 밀어내고 위로 올라온다.
b. 그게 왜 문제인가
달걀을 추천해서 고객이 달걀을 사면 Recall은 올라간다. 하지만 그 고객은 추천이 없었어도 달걀을 샀을 가능성이 높다. 추천이 실제로 더해준 가치는 거의 없고 그 자리에 들어갈 수 있었던 새 상품의 기회만 빼앗는다.
추천사유를 붙일 때도 어색하다. "삼겹살을 담으셔서 달걀을 추천해요"는 설득력이 없다. 위에서 본 높은 Recall 안에는 이런 "맞혔지만 의미 없는" 추천이 섞여 있다.
3) 문제해결 - 인기도로 나누기
생필품 쏠림을 줄이는 가장 단순한 방법은 "인기 있는 상품일수록 점수를 깎는 것" 이다. 모델을 다시 학습할 필요 없이 EASE가 낸 점수를 상품의 인기도로 나눠 순서만 다시 매긴다.
조정 점수 = EASE 점수 ÷ (인기도)^β
인기도는 학습기간에 담긴 장바구니 수
β 는 인기 상품을 얼마나 깎아 내릴지 정하는 값 0이면 원래 EASE
β=0.5라면 인기도가 10,000인 상품은 점수를 100으로, 1,000,000인 상품은 1,000으로 나눈다. 원래 점수가 같아도 인기 상품의 조정 점수는 10분의 1이 된다.
11월 검증 장바구니 2만 개로 β를 바꿔가며 비교를 했다.
Recall과 함께 추천이 얼마나 인기 상품에 쏠려 있는지 (인기 상위 100위 비율, 추천 상품의 인기 순위 중앙값) 와 얼마나 다양한지 (2만 개 장바구니 추천에 한 번이라도 등장한 상품 수) 를 봤다.
| 방식 | 전체 Recall | 처음 사는 상품 | 재구매 상품 | 인기 상위 100위 비율 | 인기 순위 중앙값 | 추천된 상품 종류 |
|---|---|---|---|---|---|---|
| 원래 EASE | 0.283 | 0.253 | 0.319 | 47.1% | 119위 | 7,346 |
| β=0.25 | 0.270 | 0.259 | 0.284 | 28.4% | 547위 | 9,730 |
| β=0.5 | 0.232 | 0.245 | 0.216 | 11.0% | 1,948위 | 12,726 |
| β=0.75 | 0.172 | 0.201 | 0.138 | 2.4% | 5,764위 | 13,946 |
| β=1.0 | 0.103 | 0.133 | 0.068 | 0.2% | 13,823위 | 12,224 |
β=0.25는 전체 Recall을 1.3%p만 잃으면서 인기 상위 100위 비율을 47%에서 28%로 낮추고 추천에 등장하는 상품 종류를 3분의 1 늘렸다. 무엇보다 맥락이 필요한 "처음 사는 상품" 의 Recall 이 오히려 오른 것이 주목했다.
4) 숫자 뒤에 숨은 "대체재 쏠림"
β=0.25가 정말 장바구니 맥락에 맞는 추천을 하는지 확인하기 위해, 요리 테마가 분명한 장바구니 다섯 개를 만들었다. 테마마다 상품 두 개를 담고 맥락을 제대로 읽었다면 나와야 할 재료를 미리 적어둔 뒤 추천 결과와 비교했다.
| 테마 | 장바구니 | 기대하는 재료 |
|---|---|---|
| 파스타 | 스파게티면, 토마토 파스타소스 | 올리브유, 마늘, 베이컨, 양파, 파마산 치즈 |
| 토스트·아침 | 식빵, 딸기잼 | 버터, 우유, 달걀, 슬라이스 치즈, 바나나 |
| 떡볶이 | 떡볶이떡, 어묵꼬치 | 대파, 고추장, 떡볶이 양념, 라면사리, 달걀 |
| 월남쌈 | 라이스페이퍼, 월남쌈 소스 | 파프리카, 깻잎, 오이, 크래미, 파인애플 |
| 부침개 | 부침가루, 부추 | 애호박, 오징어, 청양고추, 식용유, 막걸리 |
결과는 맥락은 잘 읽는 것으로 보였으나 같은 종류의 다른 상품이 여러개 추천 되는 것을 볼 수 있었다.
파스타 장바구니에서는 추천 10개 중 7개가 다른 맛 파스타소스 3종과 다른 모양의 파스타면 4종(펜네, 푸실리, 카펠리니 등)이었다. 떡볶이 장바구니는 10개 중 8개가 다른 떡과 다른 어묵이었고, 월남쌈은 6개가 칠리소스나 월남쌈 소스였다. 기대했던 올리브유, 떡볶이 양념, 파인애플은 그 뒤로 밀려나 거의 보이지 않았다.
a. 왜 이런 일이 생기나
모델이 틀린 걸 배운 건 아니다. 실제로 고객들은 파스타소스를 두 가지 맛으로 사고, 떡볶이를 할 때 어묵을 두 종류 담는다. EASE는 이 행동을 그대로 학습했을 뿐이다.
b. 그게 왜 문제인가
"이 요리에 무엇이 더 필요할까"를 기대하는 고객에게, 이미 담은 것과 같은 물건을 반복해서 보여주는 추천은 도움이 되지 않는다.
추천사유를 붙여도 "파스타소스를 담으셔서 다른 파스타소스를 추천해요"가 되어 설득력이 약하다.
그렇다면 같은 종류의 상품은 하나만 추천하도록 막으면 되지 않을까. 실제로 그렇게 해봤고, 결과는 예상과 다르게 흘러갔다.
5) 문제해결 - 소분류 제한과 최적의 조합
a. 같은 종류는 추천하지 않기 또는 조절가능하게 하자
소분류당 N개 제한은 점수 순서대로 내려가면서, 그 상품의 소분류가 이미 N개 찼으면 건너뛰는 방식이다. 장바구니가 아니라 추천 목록에 거는 제한이라, N=1이면 추천 목록에 파스타소스가 한 개만 나온다. 당연히 N=2 면 2개까지는 추천을 한다.
장바구니 소분류 제외는 장바구니에 담긴 상품의 소분류를 처음부터 꽉 찬 것으로 보고 아예 추천하지 않는 방식이다. 파스타소스를 담았다면 다른 파스타소스는 하나도 나오지 않는다.
테마 장바구니로 점검하니 테마별 기대 재료 25개 중 추천 10개 안에 나온 개수가 원래 EASE 8개, β=0.25 6개에서, β=0.25에 두 제한을 모두 걸자 15개로 늘었다. 파스타에서는 올리브유, 모짜렐라, 베이컨, 마늘이, 떡볶이에서는 떡볶이 양념과 사리면이 올라왔다.
b. 그런데 Recall이 무너졌다
검증 장바구니 2만 개로 평가하자 정반대 결과가 나왔다. 테마 점검에서 가장 좋았던 조합(β=0.25 + 소분류당 1개 + 장바구니 소분류 제외)의 전체 Recall은 0.283에서 0.105로, 처음 사는 상품 Recall은 0.253에서 0.072로 떨어졌다. 눈으로는 좋아졌는데 숫자는 무너진 것이다.
c. 정답을 나눠보니 지표가 문제였다
Recall이 무엇을 맞혀서 높았는지 확인하기 위해, 가린 정답 35,863개를 세 유형으로 나눴다.
| 정답 유형 | 비율 | 예 |
|---|---|---|
| 장바구니와 같은 소분류 (대체재) | 32.6% | 어묵을 담은 장바구니의 다른 어묵 |
| 다른 소분류 + 처음 사는 상품 (보완재) | 35.0% | 떡볶이떡을 담은 장바구니에서 처음 사보는 떡볶이 양념 |
| 다른 소분류 + 재구매 (습관적 재구매) | 32.4% | 늘 사던 우유 |
원래 EASE는 대체재 정답을 56% 맞혔지만 보완재 정답은 10%만 맞혔다. 전체 Recall 0.283 중 약 3분의 2가 대체재를 맞혀서 나온 점수였다.
소분류 제한은 바로 이 대체재를 일부러 빼는 방법이니 Recall이 떨어지는 게 당연했다.
d. "재료를 추천한다" 라는 목적
"재료를 추천한다"는 목적에 맞게 보완재 Recall, 즉 다른 소분류이면서 처음 사는 정답만으로 계산한 Recall을 새 지표로 삼아 다시 비교했다.
| 방식 | 전체 Recall | 대체재 정답 Recall | 보완재 Recall | 인기 상위 100위 비율 |
|---|---|---|---|---|
| 원래 EASE | 0.283 | 0.563 | 0.099 | 47.1% |
| β=0.25 | 0.270 | 0.573 | 0.095 | 28.4% |
| β=0.25 + 소분류당 1개 | 0.199 | 0.328 | 0.099 | 38.2% |
| β=0.25 + 소분류당 2개 | 0.242 | 0.450 | 0.104 | 33.9% |
| β=0.25 + 1개 + 장바구니 소분류 제외 | 0.105 | 0 | 0.112 | 42.5% |
| β=0.5 + 1개 + 장바구니 소분류 제외 | 0.077 | 0 | 0.094 | 17.3% |
| β=0.5 + 2개 + 장바구니 소분류 제외 | 0.087 | 0 | 0.109 | 16.0% |
| β=0.75 + 1개 + 장바구니 소분류 제외 | 0.031 | 0 | 0.053 | 1.6% |
소분류 제한을 걸어도 "보완재 Recall" 은 떨어지지 않았고, 장바구니 소분류 제외에서는 오히려 0.099에서 0.112로 올랐다. 무너진 것처럼 보였던 Recall은 대체재 정답을 포기한 결과였을 뿐, 재료를 맞히는 능력은 그대로이거나 더 나아졌다. 테마 점검과 숫자가 이제야 같은 방향을 가리킨다. 지표가 목적과 맞지 않으면 좋은 방법도 나빠 보인다.
남은 문제는 생필품이다. 대체재가 빠진 빈자리를 우유와 생수가 채우면서, 보완재 Recall이 가장 높은 조합도 인기 상위 100위 비율이 42.5%였다. 그래서 β를 올려봤다.
β=0.5에 소분류당 2개, 장바구니 소분류 제외를 함께 쓰면 보완재 Recall은 0.109로 거의 유지하면서 생필품 비율이 16%까지 내려간다.
6) 결론 - 목적에 따라 조합이 다르다
모든 지표에서 1등인 조합은 없었다. 결국 추천 영역의 목적을 먼저 정하고, 그 목적에 맞는 지표로 골라야 한다.
| 추천 영역 | 목적 | 기준 지표 | 조합 |
|---|---|---|---|
| 함께 산 상품 | 고객이 실제로 더 담을 상품 | 전체·처음 사는 상품 Recall | β=0.25, 제한 없음 |
| 이 요리에 필요한 재료 | 장바구니를 완성할 다른 종류의 상품 | 보완재 Recall + 생필품 비율 | β=0.5 + 소분류당 2개 + 장바구니 소분류 제외 |
04.추천 모델 테스트 하기
이번 포스트에서 다룬 추천모델을 직접 확인해 볼 수 있도록 데모 페이지를 작성했다.

클릭하여 테스트 페이지로 이동