LoRA 에 대한 이야기 그리고 지난 실험에서 결합이 충돌한 이유


들어가며
지난 포스트에서는 부산 사투리를 배운 캐릭터 LoRA 와 의료 상담을 배운 LoRA 를 합쳐 보는 실험을 했다.
이번 글에서는 한 걸음 물러서서, LoRA가 실제로 무엇을 학습하는지 정리해 본다. 수식은 최소한으로 쓰고, 곱셈표 하나로 설명해 보려고 한다.
01.모델은 거대한 숫자 표다
언어모델 안에는 글자도 문법 규칙도 없다. 가중치 행렬(weight matrix)이 수백 개 있을 뿐이다. 숫자가 가로세로로 빼곡히 적힌 표라서 "숫자표" 라고 부르겠다. 짧게 W 라고 쓴다.
질문이 들어오면 글자를 숫자로 바꾸고, 이 숫자 표들과 차례로 곱하고 더해서 다음 단어를 고른다. Gemma 3 4B에는 이런 숫자가 약 40억개 들어있다.
학습은 이 "숫자표" 안의 숫자를 고치는 일이다. 모델이 표준어로 답했는데 사투리를 원한다면 정답과 다른 만큼 숫자를 조금씩 바꾼다. 이걸 수천 번 반복하면 모델의 말투가 바뀐다.
02.학습결과 = 원래 표 + 바뀐 양
학습이 끝난 숫자 표는 원래 표에 바뀐 만큼을 더한 것으로 쓸 수 있다. 이 바뀐 만큼을 "변화량(ΔW)"이라고 하는데 이 포스트에서는 "바뀐 양" 이라고 부르겠다.
새 숫자표 = W + ΔW
Δ 델타는 수학에서 변화량을 뜻한다. 온도가 20도에서 25도가 되면 Δ온도가 +5 인 것 처럼 표의 한 칸이 0.50 에서 0.53 이 되면 그 칸의 ΔW는 +0.03이다.
문제는 바뀐 양도 원래 숫자표와 크기가 똑같다는 점이다. 4096 × 4096 크기의 표라면 바뀐 양도 약 1,677만 칸을 모두 학습해야 한다. 모델전체를 다시 학습하는 방식(전체 미세조정 full fine-tuning) 이 비싼 이유다. LoRA 는 이 바뀐 양을 훨씬 적은 숫자로 만드는 방법을 쓴다.
03.LoRA 의 아이디어 (바뀐 양을 곱셈표로 만든다)
LoRA 는 바뀐 양을 두 개의 작은 행렬 B 와 A 의 곱으로 만든다. 이를 저랭크 분해 (low-rank decomposition) 라고 하는데 구구단표처럼 세로 숫자와 가로 숫자를 곱해 표를 채우는 방식이라 이 글에서는 "곱셈표" 라고 부르겠다.
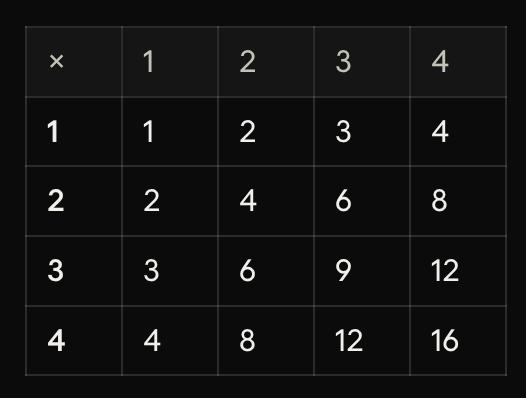
세로 숫자 4개 (B) 와 가로 숫자 4개 (A), 합쳐서 8개만 학습하면 16칸짜리 바뀐 양이 저절로 만들어진다. 4096 크기의 표라면 8,192 개로 1,677 만 칸을 만드는 셈이다.
새 숫자 표 = W + ΔW = W + B × A
W+BA 는 새로운 공식이 아니다. 원래 숫자 표에 바뀐 양을 더하되, 그 바뀐 양을 곱셈표 방식으로 만들었다는 뜻일 뿐이다. 원해 "숫자표" W 는 학습 내내 고정(freeze) 해두고 B 와 A 만 학습한다.
04.r과 alpha (곱셈표의 개수와 세기)
1) r: 곱셈표를 몇 장 겹칠까
r 은 곱셈표를 몇 장 만들어 겹쳐 더할지 정하는 숫자다. r 이 1이면 곱셈표 한 장, r 이 8 이면 여덟 장을 만들어 더한다.
여러 장을 겹치는 이유는 곱셈표 한 장으로 만들 수 있는 바뀐 양은 단순한 모양뿐이기 때문이다. 예를 들어 물감이 한 가지 색뿐이면 그릴 수 있는 그림이 제한되지만, 색이 늘어나면 더 다양한 그림을 그릴 수 있는 것과 같다. 곱셈표도 여러 장을 겹치면 숫자 표를 더 다양하게 바꿀 수 있다.
대신 장 수만큼 학습할 숫자도 늘어난다. 그리고 너무 많으면 학습 데이터만 그대로 외워 처음 보는 질문에는 오히려 약해질 수 있다. 과적합(overfitting) 이 발생하는 것이다.
그러면 몇 장을 겹칠지는 어떻게 정할까. 보통 4, 8, 16, 32 등 2의 거듭제곱으로 정하고 처음에는 8이나 16 를 많이 쓴다. 이전 포스트에서도 8에서 시작해서 16으로 올린바 있다.
2) alpha: 완성된 바뀐 양의 세기
곱셈표를 다 더한 뒤 마지막에 alpha ÷ r 을 곱한다. 이를 스케일링(scaling)이라고 하는데 무늬는 그대로 두고 세기만 바꾸는 볼륨 역할이다.
r 로 나누는 이유는 장 수가 늘면 합계가 자연히 커지기 때문이다. 그래서 alpha 를 고정하고 r 만 올리면 오히려 세기가 약해진다. r 을 바꿀 때 alpha 도 함께 올리는 관례(예: alpha = r × 2) 가 생긴 이유다.
05.곱셈표를 어디에 붙일까 (target_modules)
모델의 한 층 안에는 역할이 다른 숫자 표(가중치 행렬)가 7개 있다. 크게 어텐션 쪽 4개와 MLP 쪽 3개로 나뉜다.
구분 | 숫자 표 | 하는 일 |
|---|---|---|
어텐션 | q_proj, k_proj, v_proj, o_proj | 문장 속 단어들이 서로를 보고, 어떤 단어가 어떤 단어와 관련 있는지 파악한다 |
MLP | gate_proj, up_proj, down_proj | 단어 하나하나를 깊게 처리한다. 학습한 지식이 주로 이곳에 담긴다고 보는 연구가 많다 |
비유하면 어텐션은 문장을 읽으며 단어 사이의 연결을 파악하는 눈이고, MLP 는 그렇게 파악한 내용에 아는 지식을 꺼내 붙이는 머릿속 창고다.
정하는 방법은 보통 7개 전부에 붙여서 시작하고 메모리나 시간이 부족하면 MLP 쪽부터 빼서 줄인다. 여러 LoRA 를 결합할 계획이라면 모두 같은 곳에 붙인다. 지난 실험에서는 7개 전부에 곱셈표를 붙였다.
06.지난 실험 다시 보기
지난 포스트의 LoRA 결합을 한 줄로 쓴다면 다음과 같다.
W +
1.0 × (alpha ÷ r) × 캐릭터 B×A +
1.0 × (alpha ÷ r) × 의료 B×A
결합 비율 1.0 은 alpha ÷ r 위에 한 번 더 곱하는 볼륨이다. 이건 LoRA 자체의 개념이 아니라 PEFT 라이브러리의 결합 기능이다.
결합은 그냥 더하기다.
그래서 두 LoRA 가 같은 칸을 반대로 고치면 서로 깎이고, 같은 쪽으로 고치면 두 배로 과해진다. 두 효과가 모두 살아남으려면 서로 다른 칸을 고쳐야 한다.
숫자 표의 한 칸으로 예를 들어 보자. 원래 값이 0.50 인데 사투리 LoRA 는 0.54 로(+0.04), 의료 LoRA 는 0.47 로(−0.03) 바꾸고 싶어 한다. 둘을 결합하면 0.50 + 0.04 − 0.03 = 0.51 이 된다. 0.51 은 사투리 LoRA 도, 의료 LoRA 도 원한 값이 아니다.
결합도 이와 같다. 두 LoRA 가 같은 숫자 표의 같은 칸을 서로 다르게 바꾸고 싶어 하면 결합한 결과는 어느 쪽이 원한 값도 아니게 된다.
지난 실험에서 실제로 본 충돌은 두 가지였다.
형식 다툼
캐릭터 LoRA 는 짧게 말하고 끝내는 말투를 배웠고, 의료 LoRA 는 증상을 확인하는 질문을 목록으로 길게 묻는 형식을 배웠다. 둘을 합치자 캐릭터 쪽 버릇이 의료 쪽 질문 목록을 중간에 잘라 버렸다.
내용 다툼
캐릭터 학습 데이터에도 손목, 발목 같은 증상 이야기가 들어 있었다. 그래서 결합하면 처음 보는 증상을 물어봐도 캐릭터가 배운 엉뚱한 증상 질문이 섞여 나왔다.
차이를 만든 건 함께 쓰는 상황에서 배웠느냐였다.
따로 배운 두 LoRA 는 서로의 존재를 모른 채 학습했기 때문에 함께 붙였을 때의 행동은 한 번도 연습된 적이 없다.
캐릭터 LoRA 6차 개선에서는 의료 LoRA 가 켜진 상태에서 캐릭터를 학습시켰고, 그러자 형식이 무너지는 문제와 엉뚱한 증상 질문이 섞이는 문제가 함께 줄었다.
07.따로 학습해서 합치기 좋은 경우
그렇다면 따로 배운 LoRA 를 합치는 방식은 쓸모가 없을까? 지난 실험의 교훈을 거꾸로 적용하면 좋은 경우도 떠올릴 수 있다. 예를 들어 피부과 LoRA 와 정형외과 LoRA 를 따로 만들되, 둘 다 같은 문진 형식으로 답하게 하는 것이다.
이 경우 두 LoRA 는 서로 다른 내용을 배우니 같은 곳을 두고 다투지 않고, 형식이 같으니 지난 실험에서 문제였던 형식 다툼도 생기지 않을 것이다. 정리하면 형식은 같게, 내용은 다르게다.
따로 배우는 방식에는 장점도 있다. 필요한 LoRA 만 골라 끼울 수 있고, 하나를 고쳐도 나머지는 다시 학습하지 않아도 된다. 다만 이건 아직 직접 확인하지 않은 가설이다.